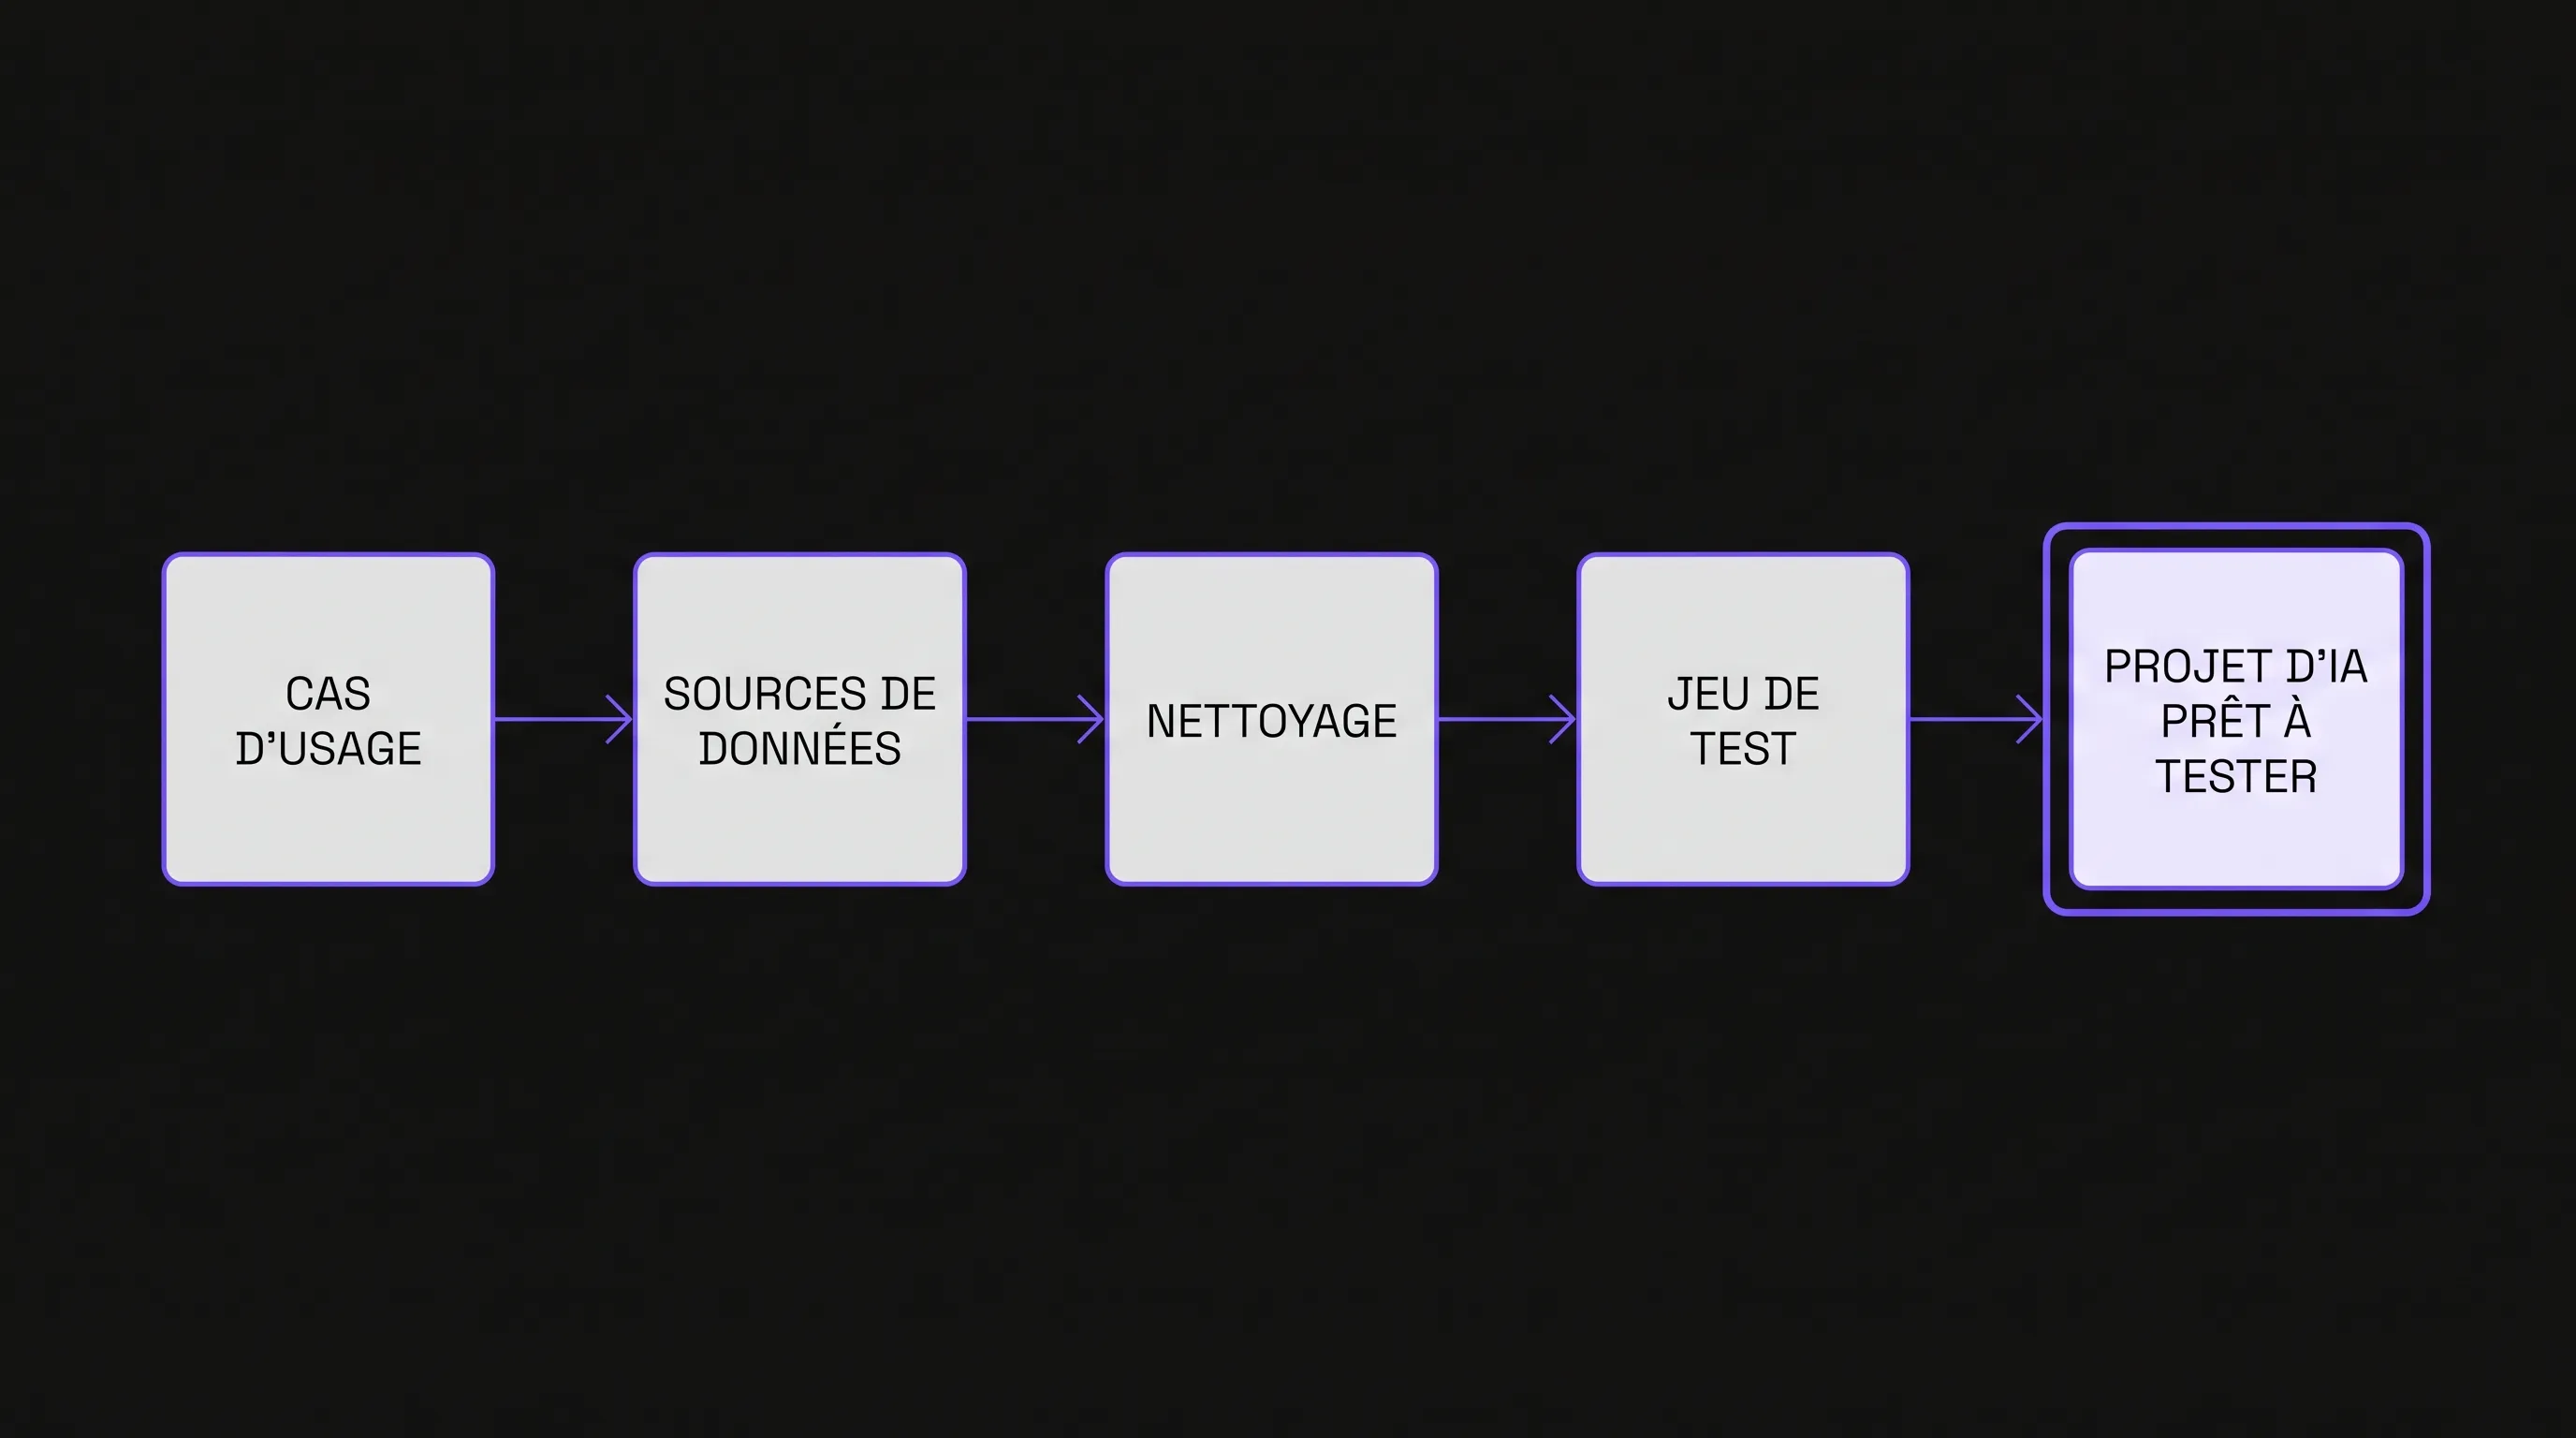
Préparer vos données avant un projet d’IA n’est pas une étape technique réservée aux data scientists. C’est le moment où l’entreprise clarifie ce qu’elle veut automatiser, quelles informations elle possède déjà, ce qu’elle peut légalement utiliser et ce qui manque pour obtenir un résultat fiable. Po...
Préparer vos données avant un projet d’IA n’est pas une étape technique réservée aux data scientists. C’est le moment où l’entreprise clarifie ce qu’elle veut automatiser, quelles informations elle possède déjà, ce qu’elle peut légalement utiliser et ce qui manque pour obtenir un résultat fiable. Pour une PME ou une scale-up, cette préparation évite de lancer un prototype séduisant mais inutilisable dès qu’il rencontre les vrais cas métier.
La bonne nouvelle, c’est qu’il n’est pas nécessaire d’avoir un entrepôt de données parfait pour démarrer. Il faut surtout savoir quelles données comptent, où elles se trouvent, qui en est responsable et comment mesurer leur qualité par rapport au cas d’usage visé.
Pourquoi les données conditionnent la réussite d’un projet d’IA
Un modèle d’IA ne crée pas de valeur à partir du vide. Qu’il s’agisse d’un assistant interne, d’un moteur de recommandation, d’une automatisation documentaire ou d’un outil de scoring commercial, il dépend toujours d’un contexte métier et de données exploitables.
Dans un projet d’IA, les erreurs les plus coûteuses viennent rarement de l’algorithme choisi au départ. Elles viennent plus souvent d’un problème mal formulé, de données dispersées entre plusieurs outils, de champs incomplets ou d’un historique qui ne reflète pas la réalité opérationnelle.
La préparation des données sert donc trois objectifs simples : réduire l’incertitude, accélérer le développement et éviter les risques de conformité. Elle permet aussi de décider plus tôt si le cas d’usage mérite un développement complet ou s’il doit être simplifié.
Si vous structurez déjà votre démarche globale, le guide d’Impulse Lab sur le processus IA de l’idée à la production complète bien cette approche orientée données.
Partir du cas d’usage avant d’ouvrir les fichiers
La tentation est forte de commencer par inventorier toutes les bases disponibles. C’est rarement le bon point de départ. Avant de préparer vos données avant un projet d’IA, vous devez préciser la décision, la tâche ou le livrable que l’IA doit améliorer.
Un cas d’usage utile se formule avec un verbe d’action : classer des demandes support, extraire des informations de contrats, prédire un risque de churn, générer un brouillon de réponse, détecter des anomalies de facturation. Cette formulation aide à distinguer les données indispensables des données simplement intéressantes.
Définir la sortie attendue
Demandez-vous ce que l’utilisateur final doit obtenir. Une probabilité ? Une réponse textuelle ? Une liste priorisée ? Une alerte ? Un résumé ? La nature de la sortie influence directement les données nécessaires.
Par exemple, un assistant de recherche documentaire a besoin de documents à jour, bien découpés et rattachés aux bons droits d’accès. Un modèle de prévision commerciale aura plutôt besoin d’historiques structurés, de dates fiables, de statuts cohérents et d’un indicateur clair de réussite ou d’échec.
Relier chaque donnée à une décision métier
Une donnée utile est une donnée qui influence une décision. Si personne ne sait expliquer comment un champ sera utilisé, il ne doit pas être prioritaire dans la première version du projet.
Cas d’usage
Données nécessaires
Risque fréquent
Priorité de préparation
Assistant support
Tickets, réponses validées, base de connaissance
Contenu obsolète ou contradictoire
Nettoyer et valider les sources
Scoring commercial
CRM, historique d’achats, statuts d’opportunités
Champs saisis de manière variable
Harmoniser les définitions
Extraction de documents
PDF, factures, contrats, champs cibles
Formats hétérogènes
Constituer un échantillon représentatif
Automatisation RH
Demandes internes, règles, workflows
Données personnelles sensibles
Vérifier droits, accès et minimisation
Cette étape de cadrage paraît simple, mais elle évite de collecter trop large. Dans un projet d’IA, trop de données mal reliées au besoin métier ralentissent autant qu’un manque de données.
Réaliser un audit de données pragmatique
Un audit de données n’a pas besoin d’être un rapport de 80 pages. Pour une première initiative, il doit répondre à une question : les données disponibles permettent-elles de tester le cas d’usage de façon crédible ?
C’est aussi le bon moment pour associer les équipes métier. Elles savent souvent pourquoi un champ est vide, pourquoi un statut est contourné ou pourquoi une base officielle n’est plus utilisée depuis six mois.
Les six critères à examiner
Pour préparer vos données avant un projet d’IA, commencez par évaluer chaque source selon six critères : disponibilité, qualité, fraîcheur, structure, droits d’usage et représentativité.
Critère
Question à poser
Signal d’alerte
Disponibilité
Les données sont-elles accessibles sans extraction manuelle complexe ?
Données bloquées chez un prestataire ou dans des fichiers locaux
Les données reflètent-elles la situation actuelle ?
Base non mise à jour, exports ponctuels, documents anciens
Structure
Les données sont-elles lisibles par un système ?
PDF scannés, fichiers non nommés, champs libres non normalisés
Droits
L’entreprise a-t-elle le droit de les utiliser pour ce traitement ?
Données personnelles sans base claire ou finalité floue
Représentativité
L’échantillon couvre-t-il les cas réels ?
Données trop propres, cas rares absents, biais de période
Ce diagnostic vous aide à prioriser. Vous n’avez pas besoin de corriger toute la donnée de l’entreprise, seulement ce qui bloque le test et la mise en production du cas d’usage choisi.
Nettoyer, structurer et documenter sans surinvestir
Le nettoyage des données devient vite un puits sans fond si personne ne fixe un périmètre. L’objectif n’est pas d’obtenir une base parfaite, mais une base suffisamment fiable pour apprendre, tester et décider.
Pour un premier projet d’IA, travaillez sur un échantillon représentatif plutôt que sur l’intégralité de l’historique. Cet échantillon doit contenir des cas simples, des cas fréquents et quelques cas limites. C’est souvent là que l’on découvre les règles métier implicites.
Normaliser ce qui influence le résultat
Les efforts doivent porter sur les éléments qui changent réellement la sortie du système. Pour un CRM, cela peut être les statuts de leads, les dates de conversion et les raisons de perte. Pour une base documentaire, cela peut être la version du document, son domaine métier, sa date de validité et son niveau de confidentialité.
Évitez de nettoyer pour nettoyer. Corriger des colonnes jamais utilisées dans le projet ne crée pas de valeur immédiate. À l’inverse, ne pas harmoniser un champ central peut rendre les résultats impossibles à interpréter.
Créer un dictionnaire de données léger
Un dictionnaire de données décrit les champs importants, leur signification, leur format et leur propriétaire. Il peut tenir dans un tableur au départ. L’essentiel est que les équipes partagent les mêmes définitions.
Par exemple, un client actif peut signifier une facture dans les 12 derniers mois pour la finance, une connexion récente pour le produit ou une opportunité ouverte pour l’équipe commerciale. Si cette définition n’est pas clarifiée, l’IA risque de renforcer une confusion déjà présente dans l’organisation.
Préparer les données selon le type de solution IA
Toutes les initiatives IA ne demandent pas la même préparation. Un projet fondé sur un grand modèle de langage, par exemple un assistant interne connecté à une base documentaire, n’a pas les mêmes besoins qu’un modèle prédictif entraîné sur des historiques chiffrés.
Comprendre cette différence permet de mieux préparer vos données avant un projet d’IA et d’éviter des efforts inutiles.
Pour un assistant IA ou un système RAG
Un système RAG, pour retrieval augmented generation, recherche d’abord les documents pertinents puis les utilise pour générer une réponse. Sa qualité dépend fortement de la qualité documentaire.
Les priorités sont alors la suppression des doublons, la mise à jour des versions, le découpage logique des contenus et la gestion des droits d’accès. Un assistant qui mélange une procédure obsolète avec une procédure récente donnera une réponse convaincante mais dangereuse.
Il faut aussi créer un petit jeu de questions de référence. Ces questions servent à vérifier si l’assistant retrouve les bons contenus, cite les bonnes sources internes et refuse de répondre lorsque l’information manque.
Pour un modèle prédictif ou de scoring
Un modèle prédictif a besoin d’exemples passés et d’un résultat connu. Si vous voulez prédire le churn, il faut savoir quels clients sont vraiment partis. Si vous voulez prioriser des prospects, il faut une définition fiable de la conversion.
Le point critique est souvent la variable cible. Elle doit être stable, comprise par les métiers et mesurable dans le temps. Sans cible fiable, le modèle apprend sur un signal flou.
Pour cadrer ces décisions avant le développement, vous pouvez vous appuyer sur cette checklist de cadrage d’un projet IA, notamment pour aligner problème métier, utilisateurs, KPI et contraintes techniques.
Sécuriser RGPD, confidentialité et droits d’accès
La préparation des données ne se limite pas à la qualité. Elle inclut aussi le droit d’utiliser ces données dans le contexte prévu. C’est particulièrement vrai pour les données clients, collaborateurs, candidats, patients, prospects ou utilisateurs.
La CNIL rappelle dans ses ressources sur les principes clés du RGPD que les traitements doivent respecter des principes comme la finalité, la minimisation, la durée de conservation et la sécurité. Ces principes s’appliquent aussi aux projets IA.
Minimiser les données utilisées
La règle pratique est simple : si une donnée n’est pas nécessaire au cas d’usage, ne l’intégrez pas à l’échantillon. Cela réduit les risques, simplifie les tests et facilite l’acceptation interne.
Dans certains cas, vous pouvez pseudonymiser ou anonymiser les données avant l’expérimentation. Attention toutefois, une anonymisation réelle doit empêcher toute réidentification raisonnable. Une simple suppression du nom ne suffit pas toujours si d’autres champs permettent de retrouver la personne.
Gérer les accès dès le prototype
Beaucoup d’entreprises sécurisent la production mais négligent le prototype. C’est une erreur. Les exports temporaires, fichiers partagés et environnements de test peuvent contenir des informations sensibles.
Définissez qui peut accéder aux données, où elles sont stockées, combien de temps elles sont conservées et comment elles sont supprimées après le test. Ces règles n’ont pas besoin d’être lourdes, mais elles doivent être explicites.
Tester la valeur avec un échantillon avant d’industrialiser
Une fois les données préparées, ne passez pas directement à un développement complet. Testez d’abord la valeur sur un périmètre réduit. Cette étape permet de distinguer un cas d’usage prometteur d’une idée séduisante mais peu rentable.
Un bon test compare l’IA à une situation de référence. Par exemple, combien de temps prend aujourd’hui le traitement manuel ? Quel est le taux d’erreur actuel ? Combien de demandes sont escaladées ? Quel est le délai moyen de réponse ?
Ces indicateurs permettent de mesurer un gain concret. Ils évitent aussi de juger le projet uniquement sur une démonstration impressionnante. Une IA qui fonctionne sur trois exemples soigneusement choisis n’est pas encore une solution opérationnelle.
Pour aller plus loin sur l’alignement entre données, stratégie et retour sur investissement, l’article Business AI : aligner stratégie, données et ROI aide à replacer la préparation des données dans une logique business.
Checklist avant de lancer le développement
Avant de mobiliser une équipe de développement ou une agence IA, validez les points suivants avec les métiers, l’IT et les responsables de la donnée.
Le cas d’usage est formulé sous forme de tâche ou de décision métier.
Les utilisateurs finaux et le moment d’utilisation sont identifiés.
Les sources de données prioritaires sont listées avec leur propriétaire.
Les champs critiques sont définis de manière partagée.
Un échantillon représentatif est disponible pour le test.
Les données sensibles ont été identifiées.
Les droits d’accès, la conservation et la suppression sont cadrés.
Les critères de succès sont mesurables avant et après le test.
Les limites attendues du système sont documentées.
Une décision de poursuite, d’arrêt ou de simplification est prévue après le prototype.
Cette checklist n’élimine pas toute incertitude, mais elle transforme un projet d’IA en démarche pilotable. Elle donne aussi une base saine aux prestataires, équipes internes ou partenaires techniques qui devront construire la solution.
FAQ
Faut-il nettoyer toutes les données de l’entreprise avant un projet d’IA ? Non. Il vaut mieux partir d’un cas d’usage précis puis nettoyer uniquement les données nécessaires au test. Une démarche trop large consomme du temps sans garantir plus de valeur.
Quelle quantité de données faut-il pour démarrer ? Cela dépend du type de projet. Un assistant documentaire peut démarrer avec un corpus limité mais fiable. Un modèle prédictif a besoin d’un historique suffisant avec des résultats connus. Dans les deux cas, la représentativité compte plus que le volume brut.
Qui doit participer à la préparation des données ? Les métiers, l’IT, les responsables conformité et l’équipe projet doivent être impliqués. Les métiers comprennent le sens des données, l’IT connaît les systèmes et la conformité sécurise les usages.
Peut-on lancer un projet IA avec des données imparfaites ? Oui, si les imperfections sont connues et maîtrisées. Le risque vient surtout des défauts invisibles : champs mal compris, données obsolètes, biais de sélection ou indicateurs métier ambigus.
Un audit IA est-il utile avant de développer ? Oui, surtout si l’entreprise ne sait pas encore quel cas d’usage prioriser ou si les données sont dispersées. Un audit permet d’identifier les opportunités réalistes, les contraintes techniques et les premières actions de préparation.
Transformer vos données en base solide pour l’IA
Préparer vos données avant un projet d’IA, c’est réduire le risque avant d’investir dans le développement. Vous clarifiez le besoin, vous vérifiez la qualité des informations disponibles, vous sécurisez les usages et vous testez la valeur sur un périmètre maîtrisé.
Impulse Lab accompagne les PME et scale-ups dans cette phase avec des audits IA, des solutions web et IA sur mesure, de l’automatisation de processus, de l’intégration aux outils existants et de la formation à l’adoption. Si vous voulez évaluer la maturité de vos données et identifier les cas d’usage les plus réalistes, vous pouvez échanger avec l’équipe Impulse Lab.