Pourquoi vos automatisations cassent après une mise à jour SaaS
automatisationS
Productivité
No-code
Optimisation
SaaS
Une automatisation ne casse presque jamais “sans raison”. Quand un CRM, un outil de facturation, une plateforme marketing ou un helpdesk SaaS se met à jour, l’incident révèle souvent une dépendance fragile qui existait déjà : un champ renommé, un droit retiré, un connecteur modifié, une étape métier...
Une automatisation ne casse presque jamais “sans raison”. Quand un CRM, un outil de facturation, une plateforme marketing ou un helpdesk SaaS se met à jour, l’incident révèle souvent une dépendance fragile qui existait déjà : un champ renommé, un droit retiré, un connecteur modifié, une étape métier implicite ou un scénario jamais testé.
Pour une PME ou une scale-up, le problème n’est pas seulement technique. Une automatisation cassée peut bloquer l’envoi de devis, créer des doublons dans le CRM, empêcher la création de tickets support ou fausser un reporting de direction. Plus l’entreprise scale, plus ces petites ruptures deviennent coûteuses, car elles se propagent dans plusieurs outils et équipes.
Une mise à jour SaaS ne casse pas vos automatisations, elle révèle leur fragilité
Un SaaS évolue en continu : nouvelles interfaces, changements de sécurité, limites API, connecteurs natifs mis à jour, champs enrichis, workflows internes améliorés. C’est précisément l’un des intérêts du modèle : vous bénéficiez d’un produit maintenu sans gérer l’infrastructure.
Mais une automatisation est une chaîne de dépendances. Elle suppose que certaines données existent, que certains boutons restent accessibles, que certains statuts gardent le même nom et que certaines API répondent toujours de la même manière. Quand l’éditeur modifie l’un de ces éléments, même pour une bonne raison, l’automatisation peut ne plus savoir quoi faire.
Le sujet n’est donc pas “faut-il arrêter d’automatiser ?”. La vraie question est : vos automatisations sont-elles conçues comme des prototypes pratiques ou comme des composants fiables de votre système d’information ?
Les causes les plus fréquentes après une mise à jour SaaS
Les incidents se ressemblent souvent. Une tâche fonctionnait la veille, la plateforme annonce une mise à jour, puis un flux Make, Zapier, n8n, Power Automate, Airtable ou un script interne commence à échouer. Pourtant, la cause exacte varie selon le niveau d’intégration.
1. Un champ a changé de nom, de format ou de comportement
C’est le cas le plus classique. Une automatisation récupère un champ “company_name”, “deal_stage” ou “invoice_status”. Après une mise à jour SaaS, le champ est renommé, déplacé, transformé en liste déroulante ou rendu obligatoire. Le connecteur reçoit toujours une réponse, mais elle ne correspond plus à ce que le scénario attendait.
Le piège est que tout ne casse pas immédiatement. Une valeur vide peut passer inaperçue pendant plusieurs jours avant de produire des erreurs métier : devis sans raison sociale, segment marketing incomplet, reporting biaisé, relance client envoyée au mauvais moment.
2. Les permissions ou l’authentification ont été durcies
Les éditeurs SaaS renforcent régulièrement leurs règles de sécurité. Ils peuvent modifier les scopes OAuth, révoquer d’anciens tokens, imposer une authentification plus stricte ou limiter l’accès à certaines ressources selon le rôle utilisateur.
Résultat : l’automatisation n’a plus le droit de lire, créer ou modifier une donnée qu’elle utilisait auparavant. C’est fréquent quand le flux repose sur le compte personnel d’un collaborateur au lieu d’un compte technique dédié. Le jour où cette personne change de rôle, part de l’entreprise ou réinitialise son accès, l’automatisation devient dépendante d’un événement RH plutôt que d’une architecture fiable.
3. Un webhook ou un déclencheur ne renvoie plus le même événement
Les webhooks sont puissants, car ils déclenchent une action dès qu’un événement survient : nouveau lead, facture payée, ticket créé, contrat signé. Mais ils dépendent du contrat événementiel du SaaS.
Si l’éditeur modifie la structure du payload, fusionne deux événements, change le nom d’un statut ou introduit un délai de traitement, votre automatisation peut se déclencher trop tôt, trop tard ou pas du tout. Les grands éditeurs publient généralement des changelogs, comme le fait Slack pour son écosystème développeur, mais encore faut-il que quelqu’un les surveille.
4. L’interface utilisateur a changé et votre RPA ne retrouve plus ses repères
Les automatisations basées sur l’interface, souvent via RPA ou scripts de navigation, sont les plus sensibles aux changements visuels. Un bouton déplacé, un libellé modifié, un menu réorganisé ou une fenêtre modale ajoutée peut suffire à bloquer l’exécution.
Ce type d’automatisation est parfois nécessaire, surtout quand un outil ne propose pas d’API exploitable. Mais il faut accepter sa nature : elle imite un utilisateur humain. Si l’écran change, elle doit être recalibrée.
5. Les limites API, les quotas ou les temps de réponse évoluent
Une automatisation peut aussi casser sans modification visible. Un SaaS peut réduire ou ajuster ses limites d’appels API, introduire de nouveaux mécanismes anti-abus ou ralentir certains traitements pendant une migration interne.
Si votre scénario n’a pas de logique de retry, de file d’attente ou de gestion propre des erreurs, il échoue au premier délai trop long. Dans une entreprise en croissance, ce problème apparaît souvent au moment où le volume augmente : ce qui fonctionnait avec 30 leads par semaine ne tient plus avec 800.
6. La règle métier a changé, mais l’automatisation n’a pas été mise à jour
Toutes les ruptures ne viennent pas de l’éditeur SaaS. Parfois, l’entreprise change son pipeline commercial, ses catégories de clients, ses règles de facturation ou sa manière de qualifier un ticket support. Le SaaS est mis à jour pour refléter la nouvelle organisation, mais les automatisations restent alignées sur l’ancien processus.
C’est la cause la plus sous-estimée, car elle ressemble à un bug technique alors qu’elle vient d’un manque de gouvernance métier.
Cause de rupture
Exemple concret
Symptôme courant
Prévention utile
Champ modifié
Statut CRM renommé
Données manquantes ou mauvaises conditions
Contrat de données et tests
Droits changés
Token OAuth expiré
Erreur 401 ou accès refusé
Compte technique et scopes documentés
Webhook modifié
Payload enrichi ou restructuré
Déclenchement absent ou doublon
Validation du schéma d’événement
Interface modifiée
Bouton déplacé
Robot bloqué sur une étape
API prioritaire ou surveillance RPA
Quota API atteint
Trop d’appels simultanés
Échecs intermittents
Retry, file d’attente et monitoring
Règle métier changée
Nouveau pipeline commercial
Automatisation incohérente
Owner métier et revue régulière
Le niveau de fragilité dépend de votre architecture d’automatisation
Toutes les automatisations n’ont pas le même risque face aux mises à jour SaaS. Une intégration API versionnée sera généralement plus stable qu’un robot qui clique dans une interface. Un scénario no-code peut être robuste s’il est bien conçu, mais très fragile s’il empile des connecteurs sans logique d’erreur.
Type d’automatisation
Robustesse typique
Risque principal
Bon usage
RPA sur interface
Faible à moyenne
Changements visuels
Outils sans API, tâches simples
Connecteur no-code
Moyenne
Abstraction du changement réel
Prototypes, workflows non critiques
Intégration API
Bonne
Rupture de contrat ou version
Processus importants et volumes réguliers
Plateforme sur mesure
Très bonne si bien maintenue
Coût de gouvernance
Processus critiques, données complexes
Le bon choix dépend du processus, du volume, de la criticité et de la capacité interne à maintenir l’ensemble. Si votre ambition est d’automatiser des chaînes complètes entre plusieurs outils, les principes présentés dans les cas d’usage d’hyperautomatisation pour PME aident à penser au-delà du simple “connecteur entre deux apps”.
Comment éviter que vos automatisations cassent à chaque mise à jour SaaS
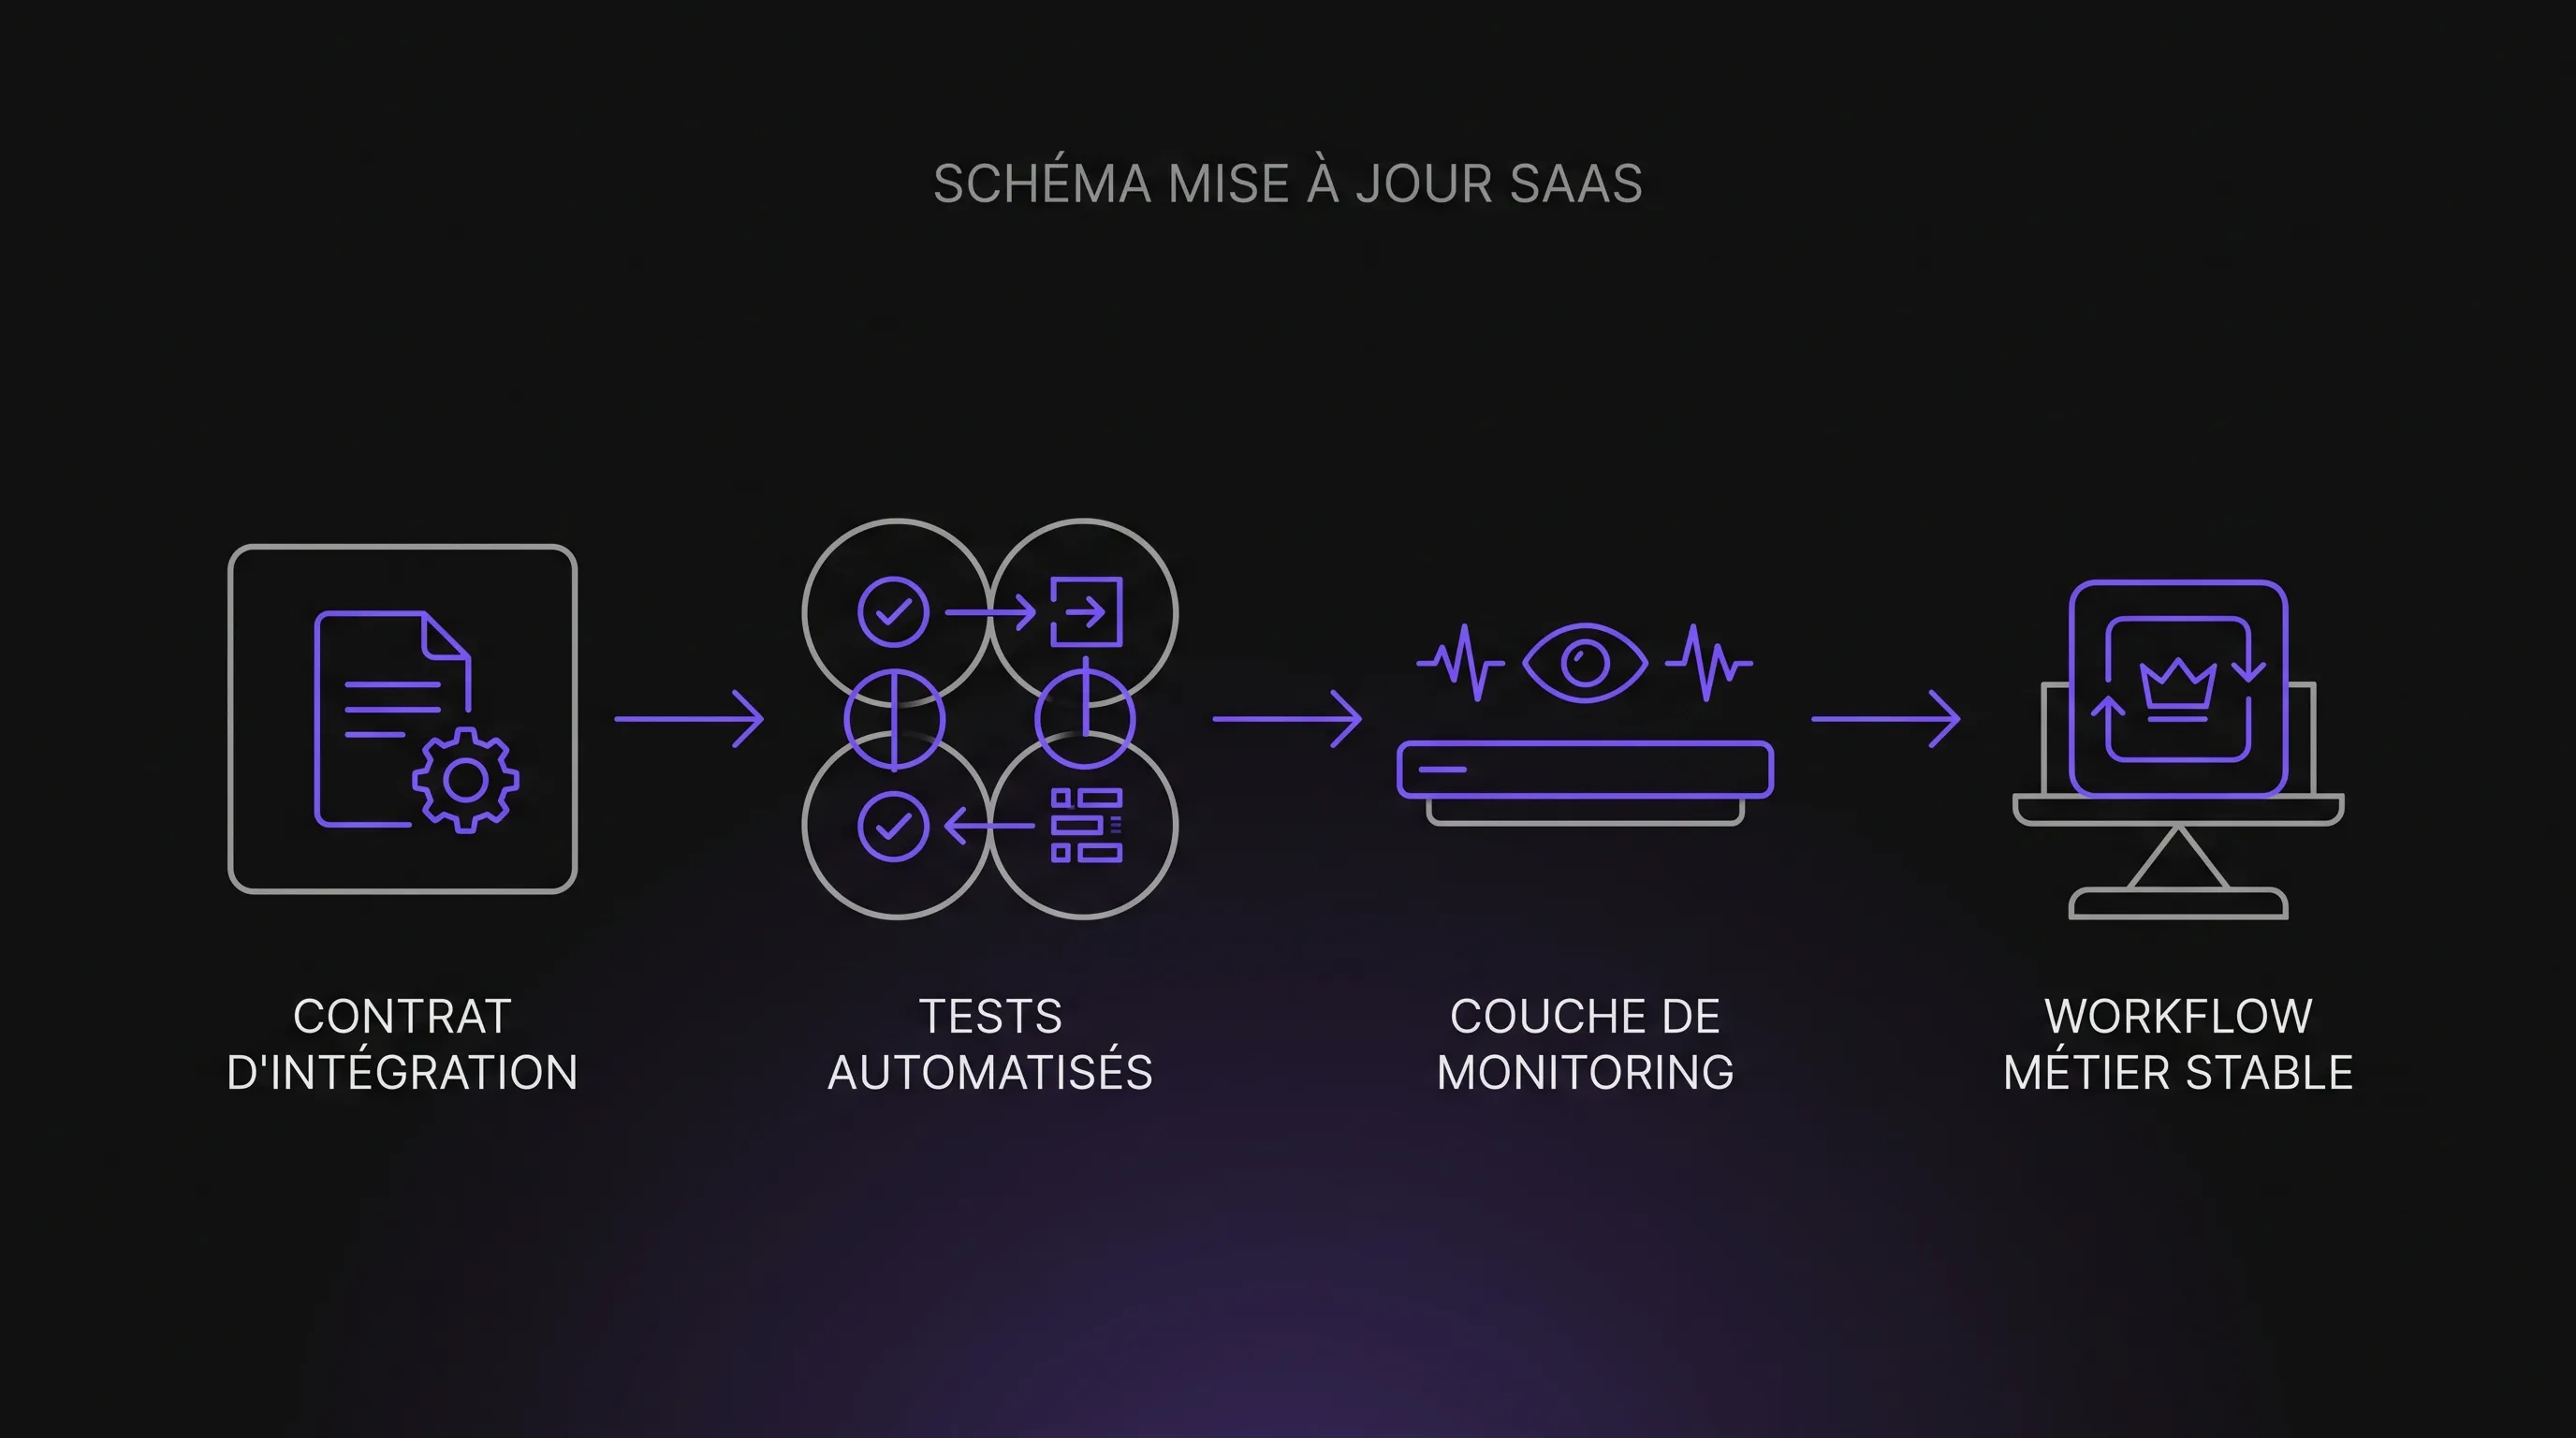
La fiabilité ne vient pas d’un outil magique. Elle vient d’une conception plus disciplinée : documenter les dépendances, séparer la logique métier de la logique technique, surveiller les erreurs et prévoir la maintenance.
Cartographier les dépendances avant d’automatiser
Avant d’ajouter un nouveau scénario, identifiez les outils impliqués, les champs utilisés, les déclencheurs, les droits nécessaires et les conséquences d’un échec. Cette cartographie peut rester simple, mais elle doit exister.
Un bon test consiste à poser cette question : “Si ce champ disparaît demain, qui le saura et quel processus sera impacté ?” Si personne ne peut répondre, l’automatisation est déjà risquée.
Privilégier les API versionnées quand le processus est critique
Quand un workflow touche au chiffre d’affaires, à la facturation, au support client ou aux données de direction, l’API est souvent préférable à une automatisation basée sur l’interface. Les API bien gérées offrent de la documentation, des codes d’erreur, des versions et parfois des périodes de transition.
Stripe, par exemple, documente son approche de versioning API, ce qui permet aux équipes techniques de contrôler le moment où elles adoptent certains changements. Tous les SaaS ne vont pas aussi loin, mais le principe reste valable : plus le contrat technique est explicite, plus l’intégration est maintenable.
Ajouter une couche d’adaptation entre vos outils
Un piège fréquent consiste à relier directement tous les SaaS entre eux. Le CRM parle au logiciel de facturation, qui parle à l’outil support, qui alimente le tableur de reporting. Au début, c’est rapide. Après quelques mois, personne ne sait plus où se trouve la logique métier.
Une couche d’adaptation peut être un middleware, une base opérationnelle, un backend léger ou une plateforme interne. Son rôle est de centraliser certaines règles : format des données, correspondance des statuts, gestion des erreurs, déduplication et transformation des événements.
Tester les scénarios sensibles avant la mise en production
Les tests ne sont pas réservés aux grandes équipes tech. Même une PME peut mettre en place des tests simples : vérifier qu’un lead test arrive bien dans le CRM, qu’une facture fictive déclenche le bon email ou qu’un ticket support conserve ses champs obligatoires.
L’objectif n’est pas de tout tester comme un produit logiciel complexe. Il s’agit d’identifier les workflows où une erreur coûte cher et de vérifier régulièrement qu’ils fonctionnent encore, surtout après une modification SaaS, un changement de connecteur ou une évolution de processus interne.
Surveiller les erreurs au lieu d’attendre les plaintes utilisateurs
Une automatisation fiable doit produire des signaux : logs, alertes, taux d’échec, temps d’exécution, nombre d’éléments traités et éléments bloqués. Sans monitoring, l’entreprise découvre souvent le problème quand un client se plaint ou quand une équipe remarque une anomalie dans un reporting.
Le minimum viable consiste à envoyer une alerte claire à un canal ou une personne responsable quand un scénario critique échoue plusieurs fois. Une erreur isolée peut être normale. Une série d’erreurs sur le même connecteur doit déclencher une investigation.
Nommer un owner métier et un owner technique
Une automatisation traverse souvent plusieurs équipes : sales, finance, opérations, support, marketing. Si personne n’en est propriétaire, elle devient un actif orphelin. Le owner métier valide la règle : quand déclencher, quoi créer, quelle exception gérer. Le owner technique garantit que l’intégration reste maintenable.
Dans les PME qui structurent leur croissance, cette gouvernance légère évite beaucoup d’incidents. Elle rend aussi les arbitrages plus simples : faut-il réparer, refactoriser ou remplacer une automatisation devenue trop fragile ?
Que faire quand une automatisation a déjà cassé ?
La pire réaction consiste à modifier le scénario au hasard jusqu’à ce qu’il “reparte”. Cela peut masquer la vraie cause et créer une dette encore plus difficile à corriger. Une réponse plus fiable suit une logique de diagnostic.
Isoler le point de rupture : déclencheur, authentification, transformation de données, action finale ou outil de destination.
Comparer la dernière exécution réussie et la première erreur : l’écart temporel aide à relier l’incident à une mise à jour SaaS, un changement interne ou un pic de volume.
Lire les messages d’erreur complets : un code 401, 429 ou 400 ne raconte pas la même histoire.
Vérifier les champs et permissions : beaucoup d’incidents viennent d’un champ obligatoire ajouté ou d’un token expiré.
Rejouer avec un cas de test contrôlé : évitez de tester directement sur des données clients sensibles.
Documenter le correctif : si l’incident se reproduit, l’équipe ne doit pas repartir de zéro.
Une fois le flux réparé, prenez le temps d’analyser sa robustesse. Si le même type de panne revient tous les mois, ce n’est plus un incident ponctuel. C’est un signal d’architecture.
Quand faut-il remplacer une automatisation bricolée par une solution plus structurée ?
Le bricolage intelligent a sa place. Un scénario no-code peut valider une idée, gagner du temps rapidement ou automatiser une tâche non critique. Le problème commence quand un prototype devient un processus central sans avoir été renforcé.
Certains signaux doivent vous pousser à revoir l’architecture : plusieurs équipes dépendent du flux, les données alimentent la facturation ou le reporting, les exceptions augmentent, le volume explose, le scénario est incompréhensible pour une nouvelle personne ou les mises à jour SaaS déclenchent des incidents récurrents.
Dans ces cas, une approche hybride ou sur mesure peut devenir plus rentable qu’une accumulation de correctifs. La décision ne se résume pas à “SaaS ou développement custom”. Il existe des zones intermédiaires : connecteurs mieux structurés, API interne, portail métier, synchronisation de données ou application web dédiée. Pour cadrer ce choix, l’article sur le développement sur mesure ou SaaS donne un bon point de départ.
Le rôle de l’IA dans des automatisations plus résilientes
L’IA peut aider à classer des demandes, extraire des données de documents, détecter des anomalies ou générer des réponses assistées. Mais elle ne supprime pas le besoin d’une architecture solide. Une automatisation IA fragile reste fragile si elle dépend de champs instables, de prompts non versionnés ou de données mal synchronisées.
La bonne approche consiste à traiter l’IA comme un composant du processus, pas comme une couche magique qui compense l’absence de conception. Les mêmes règles s’appliquent : entrées documentées, sorties validées, seuils de confiance, logs, supervision humaine pour les cas sensibles et mesures de performance.
Si vous déployez rapidement des workflows IA, commencez par des périmètres maîtrisés. Les exemples de workflows d’automatisation IA à déployer en 30 jours sont utiles à condition d’y ajouter dès le départ les garde-fous de maintenance.
FAQ
Pourquoi mes automatisations cassent-elles après une mise à jour SaaS ? Parce qu’elles dépendent souvent d’éléments qui changent : champs, permissions, webhooks, interface, quotas API ou règles métier. La mise à jour révèle une dépendance non documentée ou non testée.
Les outils no-code sont-ils moins fiables que le développement sur mesure ? Pas forcément. Un workflow no-code bien conçu, surveillé et documenté peut être fiable. Il devient fragile quand il repose sur trop d’hypothèses invisibles, sans logs, sans owner et sans gestion des erreurs.
Faut-il toujours utiliser une API plutôt qu’un robot RPA ? Non. La RPA reste utile quand aucune API n’existe ou quand le processus est temporaire. Pour un processus critique et durable, une intégration API ou une couche d’adaptation est généralement plus robuste.
Comment savoir si une automatisation est critique ? Elle est critique si son échec bloque une vente, une facture, un client, un reporting de direction, une obligation réglementaire ou le travail quotidien de plusieurs équipes. Plus l’impact est élevé, plus elle mérite des tests et du monitoring.
Stabiliser vos automatisations avant la prochaine mise à jour
Les mises à jour SaaS ne vont pas ralentir. Vos outils continueront d’évoluer, vos processus aussi. La différence se joue dans la manière de concevoir, documenter et maintenir vos automatisations.
Impulse Lab accompagne les PME et scale-ups sur l’audit IA, l’automatisation des processus, l’intégration avec les outils existants et le développement de plateformes web et IA sur mesure. Si vos automatisations deviennent difficiles à maintenir, un audit peut aider à identifier les points de rupture, prioriser les correctifs et structurer une architecture plus fiable.
Pour transformer vos automatisations en actifs durables plutôt qu’en scripts fragiles, vous pouvez démarrer par un échange avec l’équipe via Impulse Lab.