Comment un catalogue data alimente votre intelligence artificielle
Intelligence artificielle
Stratégie IA
Outils IA
Gouvernance IA
Un catalogue de données apporte un cadre concret à vos projets « data intelligence artificielle » : il permet de savoir quelles informations existent, ce qu’elles signifient et dans quelles conditions votre IA peut les utiliser. Il ne rend pas un modèle plus intelligent à lui seul. Il aide surtout à...
octobre 27, 2026·10 min de lecture
Un catalogue de données apporte un cadre concret à vos projets « data intelligence artificielle » : il permet de savoir quelles informations existent, ce qu’elles signifient et dans quelles conditions votre IA peut les utiliser. Il ne rend pas un modèle plus intelligent à lui seul. Il aide surtout à lui fournir des sources adaptées, identifiées et contrôlées.
Pour une PME ou une entreprise en croissance, l’enjeu est très opérationnel. Avant de connecter un assistant à vos documents ou de construire un outil de prévision, vous devez distinguer les données exploitables des fichiers obsolètes, incomplets ou confidentiels. Le catalogue rend cette sélection possible sans imposer de tout centraliser.
Un catalogue décrit les données, il ne les remplace pas
Un catalogue data est un répertoire organisé des ressources informationnelles de l’entreprise : tables de bases de données, fichiers, documents, indicateurs ou interfaces de programmation. Il décrit ces ressources grâce à des métadonnées, c’est-à-dire des informations sur les données elles-mêmes.
Une base contient, par exemple, vos commandes. Le catalogue indique où trouver cette base, comment interpréter le champ « date de commande », qui peut y accéder et qui contacter lorsqu’un montant semble incohérent.
Cette distinction évite une confusion : cataloguer ne signifie ni copier toutes les données ni les transmettre automatiquement à une IA. Le stockage, la transformation et l’utilisation des informations restent assurés par d’autres composants. Certains catalogues disposent de connecteurs et de fonctions de gouvernance avancées, mais ces capacités ne sont pas universelles.
Ce que le catalogue apporte à un projet « data intelligence artificielle »
La valeur d’un catalogue tient moins au nombre de ressources référencées qu’à la qualité des réponses qu’il apporte. Une liste de noms de fichiers ne suffit pas. Pour relier data et intelligence artificielle, il faut rendre explicites le sens des informations, leur provenance et leurs limites d’utilisation.
Métadonnée
Exemple concret
Utilité pour l’IA
Définition métier
« Client actif » signifie au moins une commande payée sur douze mois
Éviter les interprétations contradictoires
Source et emplacement
Table de facturation issue de l’outil comptable
Retrouver la donnée de référence
Responsable
Personne chargée de valider les règles de remboursement
Obtenir un arbitrage métier
Version et fraîcheur
Procédure approuvée, date de dernière révision connue
Écarter une version dépassée
Sensibilité et accès
Document réservé à une équipe ou à un client
Définir les restrictions à appliquer
Règles de qualité
Identifiant obligatoire, montant exprimé en euros
Contrôler les données avant utilisation
Le catalogue peut aussi décrire la traçabilité des transformations, souvent appelée data lineage. Elle permet de comprendre comment un indicateur a été calculé et quelles sources ont contribué au résultat. Cette information devient précieuse lorsqu’une prévision ou une réponse doit être expliquée.
Comment le catalogue alimente concrètement votre IA
Le catalogue intervient en amont de l’exploitation : il aide à sélectionner les ressources, à préparer les contrôles et à documenter le contexte. L’intégration technique réalise ensuite les opérations nécessaires. Deux scénarios illustrent cette séparation.
Pour un modèle de prévision ou de classification
Imaginons un modèle chargé de prévoir les volumes de commandes. L’équipe doit identifier les historiques utilisables, comprendre les changements de statut et distinguer une vente annulée d’une vente encaissée.
Le catalogue documente ces règles et les liens entre les tables. Les traitements de préparation peuvent ensuite appliquer des contrôles : supprimer les doublons, harmoniser les unités ou signaler les périodes incomplètes.
Dans cette articulation entre data et intelligence artificielle, le catalogue permet aussi de documenter ce qui était connu au moment de la décision. Utiliser une information disponible seulement après la commande pourrait fausser l’évaluation du modèle. Le catalogue aide à repérer ce risque de fuite de données, sans le détecter automatiquement à lui seul.
Il reste nécessaire de tester les jeux de données, de conserver leurs versions et d’évaluer les performances du modèle sur des exemples distincts de ceux utilisés pour l’apprentissage.
Pour un assistant documentaire utilisant le RAG
Le RAG, ou génération augmentée par recherche, consiste à récupérer des informations dans un corpus avant de demander au modèle de formuler une réponse. Il ne nécessite pas, à lui seul, de réentraîner le modèle sur vos documents.
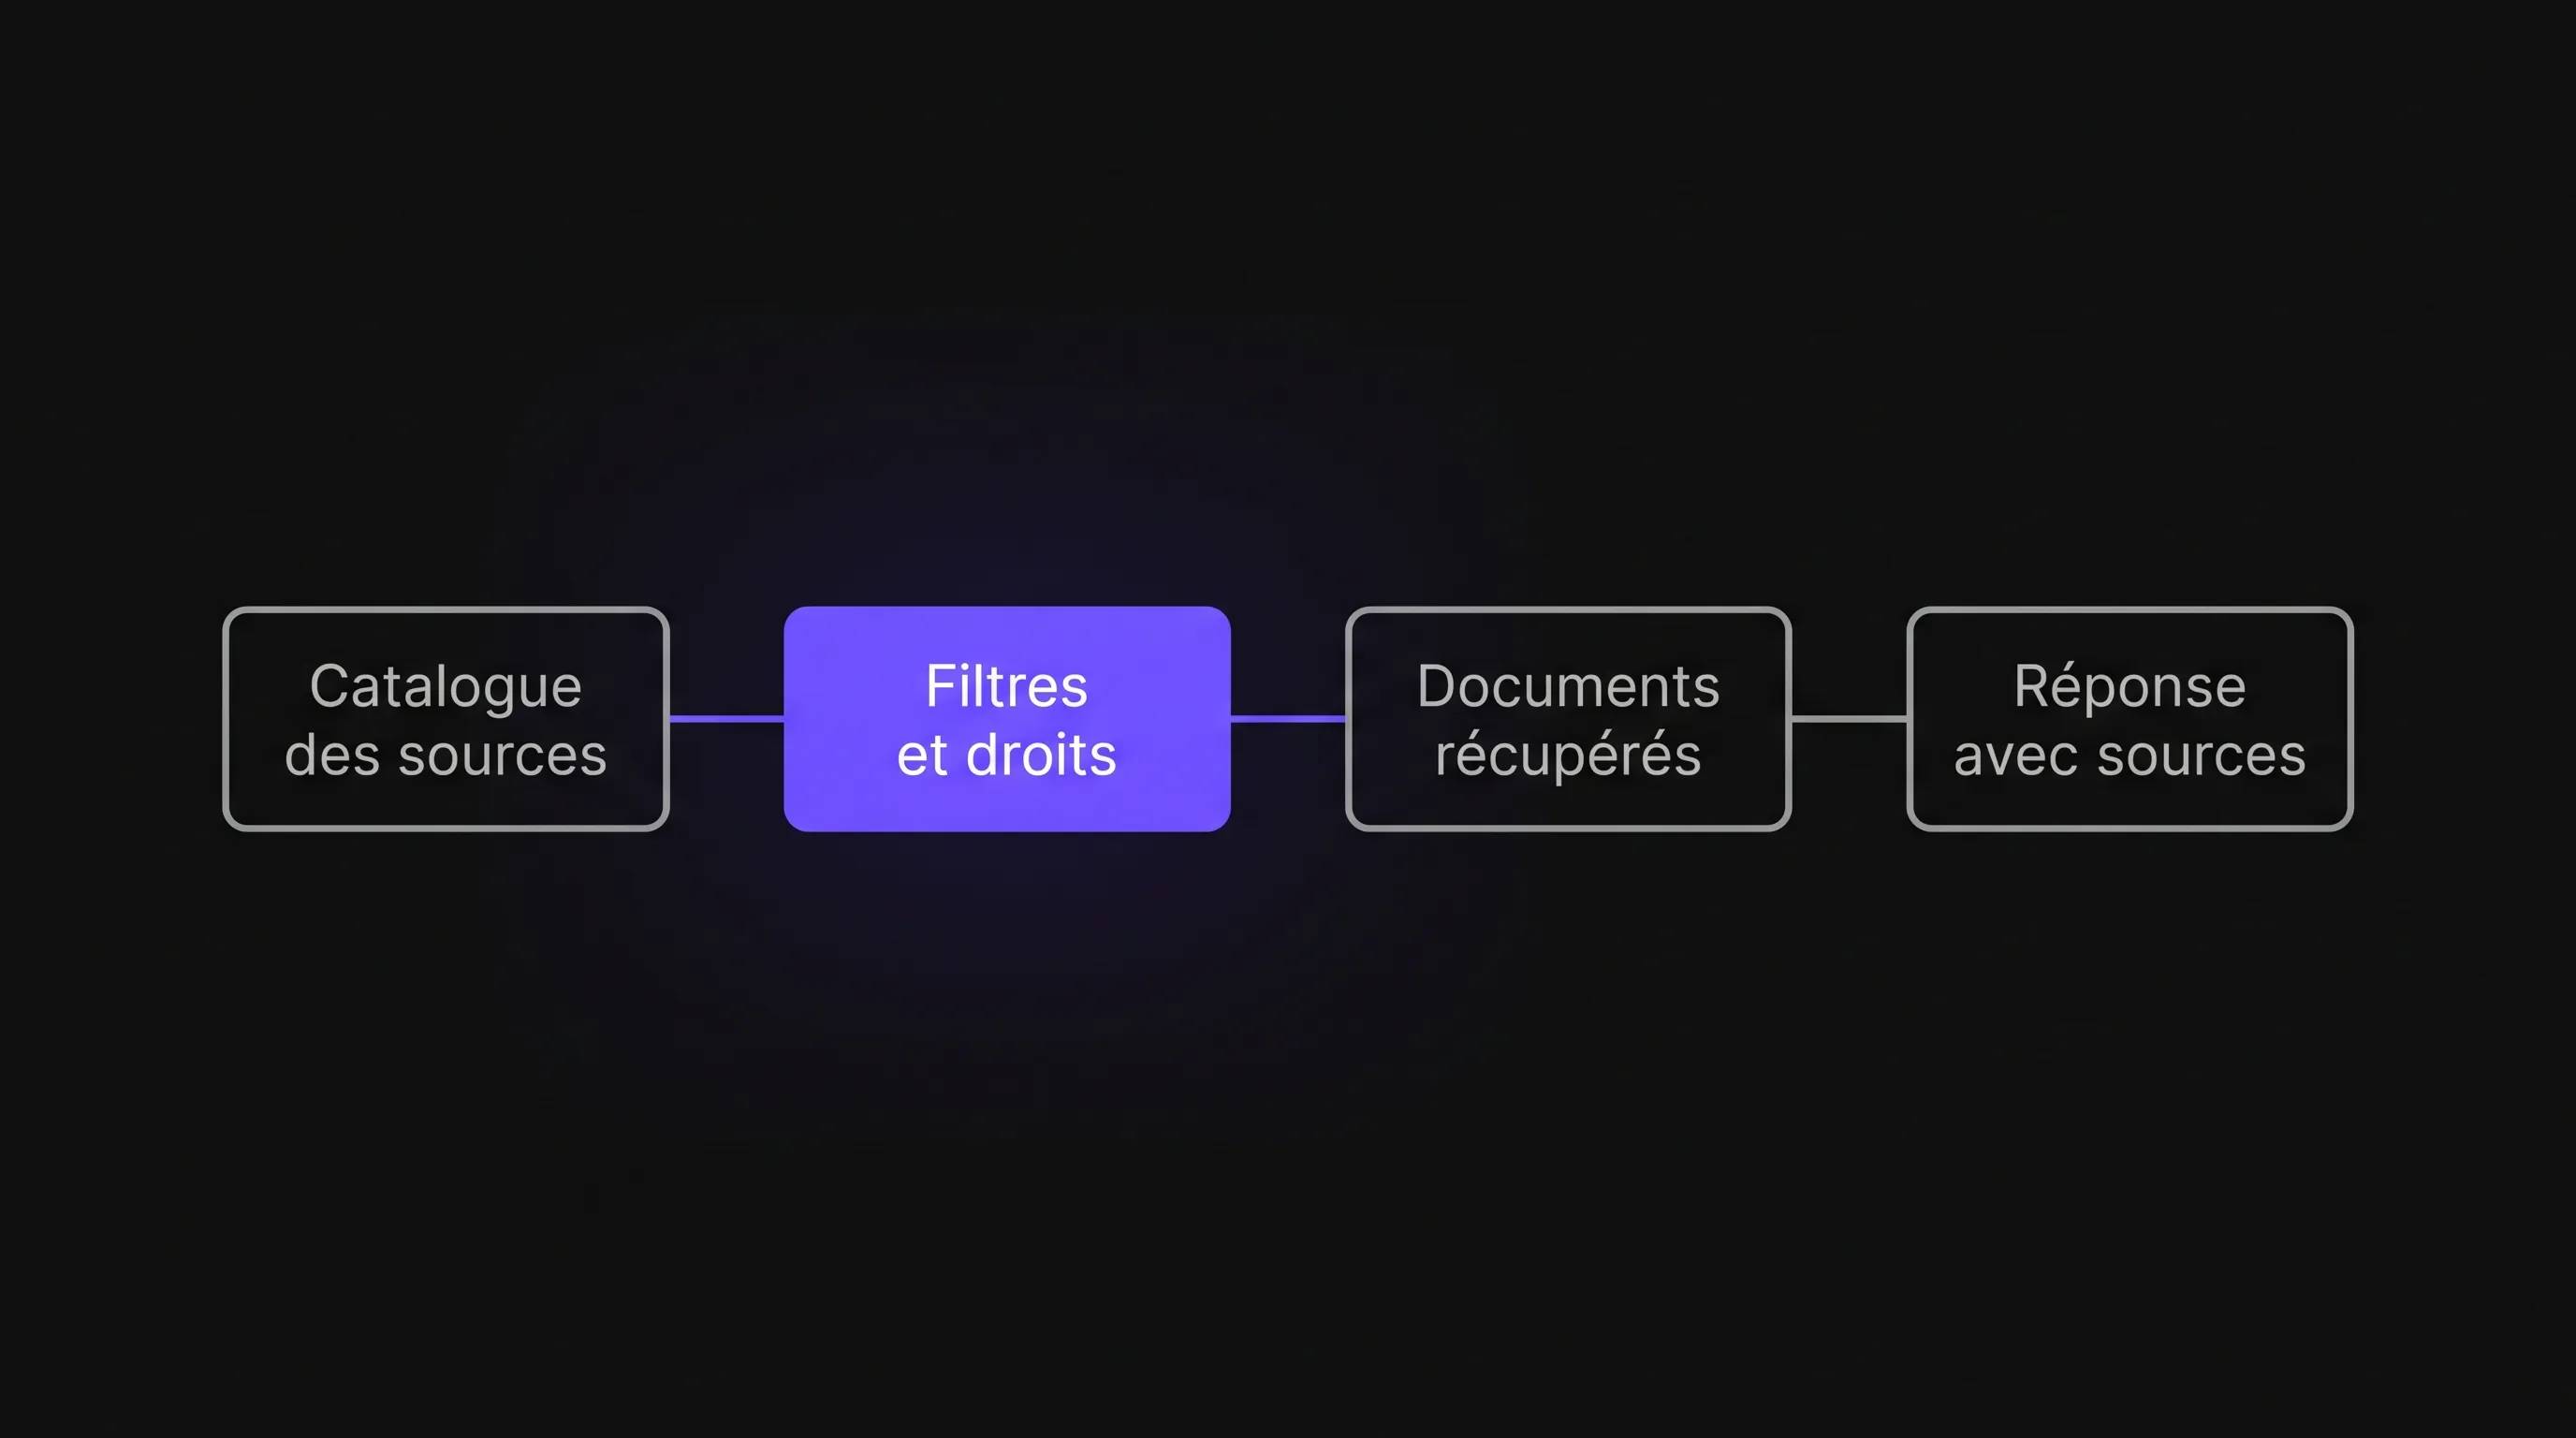
Le catalogue aide à définir le corpus autorisé : procédures approuvées, documentation produit publiée ou contrats accessibles à l’utilisateur. Un traitement récupère ensuite les contenus, les découpe et les indexe pour la recherche.
À chaque question, le système doit sélectionner des extraits pertinents en respectant les droits de la personne qui interroge l’assistant. Une métadonnée « confidentiel » n’offre aucune protection si le moteur de recherche ignore cette restriction.
Le catalogue doit donc être relié aux mécanismes d’accès et de mise à jour. Une procédure retirée doit être exclue des recherches. Une nouvelle version doit déclencher le traitement prévu. Le modèle peut alors recevoir les bons extraits, accompagnés de références permettant à l’utilisateur de vérifier la réponse.
Exemple : un assistant support qui distingue les bonnes procédures
Prenons un cas illustratif. Une entreprise dispose d’articles d’aide, de procédures internes et de conditions commerciales qui varient selon les contrats. Elle souhaite assister son équipe support.
Sans travail préalable sur les sources, le moteur de recherche peut remonter une ancienne politique de remboursement simplement parce qu’elle correspond bien aux mots de la question. La réponse sera convaincante, mais inadaptée au contrat concerné.
Pour cet usage associant data et intelligence artificielle, le catalogue peut référencer le statut d’approbation du document, sa période de validité, le produit concerné et les catégories d’utilisateurs autorisées.
L’intégration applique ensuite ces informations comme critères de sélection. Si le contrat du client n’est pas identifié, l’assistant demande une précision plutôt que de choisir arbitrairement une règle. Si aucune source valide n’est trouvée, il transmet la demande à un humain.
Le gain attendu n’est donc pas seulement une meilleure recherche. C’est la possibilité de fixer une limite claire : l’IA répond à partir d’une source admissible ou signale qu’elle ne peut pas conclure.
Construire un premier catalogue utile sans chantier disproportionné
Une entreprise qui commence à structurer ses données n’a pas nécessairement besoin d’une plateforme dédiée dès le premier jour. Un registre partagé peut servir de point de départ, à condition de rester limité, maintenu et relié à un usage précis.
Partir d’une décision ou d’une tâche métier
Choisissez d’abord un résultat : retrouver une procédure applicable, préparer une prévision ou vérifier une information produit. Identifiez ensuite les seules sources nécessaires à cette tâche.
Un premier périmètre peut se limiter aux procédures approuvées d’une équipe. Chercher immédiatement à inventorier tous les fichiers de l’entreprise rendrait la validation plus difficile sans améliorer nécessairement le premier usage.
La bonne question pour rapprocher data et intelligence artificielle est : « Quelles informations devons-nous pouvoir retrouver, comprendre et autoriser pour cette tâche ? » Elle donne un critère concret pour décider ce qui entre dans le catalogue.
Désigner un responsable capable de valider le sens
Chaque source doit avoir un responsable identifiable. Son rôle n’est pas forcément de gérer l’infrastructure : il doit pouvoir confirmer la définition métier, décider si une version reste valable et arbitrer les anomalies.
L’équipe technique prend en charge les connecteurs, les traitements et l’application des règles. Cette séparation évite de demander à un développeur de décider seul quelle politique commerciale fait foi.
Transformer la documentation en contrôles vérifiables
Une mention « données fiables » n’est pas un contrôle. Précisez les conditions d’acceptation et la réaction attendue lorsqu’elles ne sont pas remplies.
Pour un premier périmètre documentaire, quelques règles suffisent à cadrer le fonctionnement :
Une source sans responsable ou sans statut d’approbation reste hors du corpus de production.
Une modification des droits déclenche la mise à jour des accès dans les systèmes qui utilisent le contenu.
Une version remplacée est retirée de la recherche selon un délai défini.
Une réponse sans source admissible entraîne une demande de précision ou une transmission à un humain.
Ces règles doivent être testées dans l’application, pas seulement inscrites dans le catalogue. C’est à ce stade que la relation entre data et intelligence artificielle devient un fonctionnement contrôlable plutôt qu’une intention.
Encadrer les accès et les données personnelles
Le catalogue peut aider à repérer les données personnelles, leurs finalités et les restrictions applicables. Il ne constitue pas, à lui seul, une preuve de conformité.
Le RGPD, notamment ses articles 5 et 25, encadre entre autres la minimisation, l’exactitude et la protection des données dès la conception. Pour votre projet, cela implique de vérifier quelles informations sont réellement nécessaires, sur quelle base elles sont traitées et pendant combien de temps elles sont conservées.
Un assistant qui explique une procédure de remboursement n’a pas nécessairement besoin d’accéder aux coordonnées bancaires des clients. Écarter ces champs en amont réduit l’exposition sans dégrader cet usage.
Pensez également aux copies : index de recherche, caches, journaux et contenus transmis à un prestataire. Retirer un accès dans le catalogue ne le retire pas automatiquement partout. La propagation des changements doit être prévue et vérifiée.
Enfin, le catalogue lui-même mérite une protection. Ses descriptions peuvent révéler l’existence de projets confidentiels ou contenir des exemples sensibles. Évitez d’y copier des données personnelles lorsque des descriptions neutres suffisent.
Mesurer ce que le catalogue change vraiment
Le nombre de ressources cataloguées mesure l’effort d’inventaire, pas la fiabilité de l’IA. Pour évaluer l’association entre data et intelligence artificielle, observez plutôt les résultats sur un ensemble de situations représentatives du travail réel.
Indicateur
Comment le vérifier
Pertinence des sources
Faire valider par le métier les documents retenus pour chaque question test
Respect des autorisations
Essayer la même demande avec plusieurs profils d’accès
Gestion des changements
Modifier, retirer ou remplacer une source et vérifier sa prise en compte
Qualité des réponses
Contrôler l’exactitude, les références et le refus de conclure sans preuve
Conservez aussi les cas où le système échoue : documents contradictoires, contexte manquant ou source inaccessible. Ils permettent de distinguer un problème de données d’un problème de recherche ou de génération.
Avant d’élargir le périmètre, vérifiez que ces tests restent satisfaisants après une mise à jour. Une démonstration réussie ne remplace pas un contrôle reproductible.
Questions fréquentes
Faut-il un catalogue pour démarrer un projet d’IA ? Pas systématiquement sous la forme d’un logiciel dédié. Un usage limité peut commencer avec un registre simple. Il faut néanmoins identifier les sources, leurs responsables, leur validité et leurs conditions d’accès. Le besoin d’outillage augmente avec le volume, les changements et la diversité des utilisateurs.
Quelle différence entre catalogue de données et dictionnaire de données ? Le dictionnaire décrit surtout la structure et le sens des champs : format, unité, définition ou valeurs possibles. Le catalogue couvre plus largement la découverte des ressources, leur contexte métier, leur provenance et leurs conditions d’utilisation. Il peut intégrer un dictionnaire.
Un catalogue empêche-t-il les hallucinations ? Non. Il améliore la sélection et la compréhension des sources, mais un modèle peut encore mal interpréter un extrait ou produire une affirmation non étayée. Il faut aussi encadrer la recherche, demander des références et prévoir une réponse d’incertitude.
Peut-on garder les données dans les outils existants ? Oui, un catalogue peut référencer des ressources sans les centraliser. En revanche, le traitement IA peut nécessiter des extractions ou des index. Ces copies doivent être identifiées, sécurisées et mises à jour selon les règles du projet.
Cadrer votre premier usage avec Impulse Lab
Pour structurer vos projets data et intelligence artificielle, commencez par une tâche précise, un périmètre de sources et des critères de validation. Vous saurez ensuite quelles métadonnées documenter et quelles intégrations développer.
Impulse Lab accompagne les entreprises avec des audits d’opportunités IA, des développements sur mesure et des formations à l’adoption. Un audit peut servir à cadrer votre cas d’usage et les prérequis liés aux données avant d’engager le développement d’une solution.