Intelligence artificielle et machine learning pour prévoir la demande
Intelligence artificielle
Stratégie d'entreprise
Optimisation
Sales
Derrière la recherche « intelligence artificielle machine learning », une question très concrète se pose pour une PME : comment anticiper les commandes sans immobiliser trop de trésorerie ni multiplier les ruptures ? Prévoir la demande consiste à estimer ce que les clients voudront acheter, à un hor...
octobre 28, 2026·15 min de lecture
Derrière la recherche « intelligence artificielle machine learning », une question très concrète se pose pour une PME : comment anticiper les commandes sans immobiliser trop de trésorerie ni multiplier les ruptures ? Prévoir la demande consiste à estimer ce que les clients voudront acheter, à un horizon utile pour agir.
L’IA peut aider à repérer des régularités et à exploiter plusieurs signaux, mais elle ne remplace ni des données fiables ni une décision d’approvisionnement bien définie. L’objectif n’est pas de produire une courbe impressionnante. Il est de mieux choisir quoi commander, quand et dans quelles quantités, avec une incertitude explicite. Cela vaut aussi pour prévoir la charge d’un service ou les besoins d’une équipe en croissance.
« Intelligence artificielle machine learning » : comprendre ce que l’on prévoit
L’intelligence artificielle désigne un ensemble de méthodes permettant à un système d’accomplir des tâches comme reconnaître des motifs, classer ou prévoir. Le machine learning, ou apprentissage automatique, en est une branche : les modèles apprennent des relations à partir d’exemples plutôt que d’appliquer uniquement des règles écrites à la main.
Pour prévoir des ventes, on utilise généralement de l’apprentissage supervisé. Le modèle relie des informations disponibles à une date donnée à une quantité observée ensuite. L’apprentissage non supervisé peut regrouper des produits aux comportements proches. L’apprentissage par renforcement concerne des décisions successives et n’est généralement pas le point de départ d’un projet de prévision.
Le deep learning repose sur des réseaux de neurones et appartient lui aussi au machine learning. Il n’est pas indispensable pour une PME. Un modèle statistique ou un algorithme plus simple peut mieux convenir à son historique.
La demande n’est pas toujours égale aux ventes enregistrées. Un article indisponible peut afficher zéro vente alors que des clients souhaitaient l’acheter. Confondre les deux conduit à reproduire les ruptures.
Partir de la décision, pas de l’algorithme
Avant d’associer intelligence artificielle et machine learning, précisez la décision à améliorer. Un distributeur qui attend trois semaines une livraison ne doit pas seulement prévoir les ventes du lendemain. Son horizon doit couvrir le temps nécessaire pour réagir.
Définissez la quantité attendue, le niveau de détail et la fréquence de mise à jour. Une prévision hebdomadaire par famille aide à préparer un budget. Une prévision par référence et entrepôt sert davantage au réapprovisionnement. Pour planifier des équipes, la variable pertinente sera plutôt un volume de dossiers ou d’interventions.
Le bon niveau de précision dépend aussi du volume disponible. Découper quelques commandes mensuelles par produit, canal et région peut créer des séries trop dispersées pour être utiles. Mieux vaut parfois prévoir à un niveau agrégé, puis répartir avec une règle transparente.
Fixez enfin l’arbitrage économique : manque à gagner en cas de rupture, coût du stockage, risque de péremption et capacité opérationnelle. Une entreprise qui vend des produits périssables ne pénalise pas une surestimation comme un fournisseur de pièces critiques pénalise une sous-estimation. Ces choix déterminent ce que signifie une « bonne » prévision.
Des données exploitables, pas seulement un historique de ventes
Un projet associant intelligence artificielle et machine learning commence par des données fiables. Les données prioritaires sont les commandes ou ventes datées, les quantités, les références et les lieux de vente. Ajoutez les stocks disponibles, les retours, les prix et les promotions lorsque ces informations sont fiables. Les délais fournisseurs sont nécessaires pour transformer les prévisions en commandes.
Conservez une trace des périodes de rupture. Une absence de vente liée à une indisponibilité ne doit pas être interprétée comme une baisse d’intérêt. Toute correction de demande non observée doit être documentée : les ventes perdues restent une estimation, pas une vérité reconstituée.
Les calendriers apportent souvent des variables utiles : jours ouvrés, vacances, fêtes et événements connus. La météo peut compter dans certains métiers, mais seules les prévisions météorologiques réellement accessibles au moment de décider doivent entrer dans une simulation historique réaliste.
Aucun nombre universel de mois d’historique ne garantit la réussite. Plusieurs cycles facilitent l’étude d’une saisonnalité annuelle ; quelques mois ne permettent pas de la mesurer solidement. Des données anciennes peuvent aussi devenir peu représentatives après un changement d’activité.
Contrôlez enfin les doublons, les unités, les changements de référence et la distinction entre valeur manquante et zéro. Une commande annulée ou une migration d’ERP mal interprétée peut dégrader davantage la prévision qu’un mauvais choix d’algorithme.
Exemple filé : une PME et 300 références
Prenons un exemple fictif : une PME de commerce en ligne vend 300 références d’accessoires pour la maison. Elle dispose de 30 mois de ventes quotidiennes, avec des historiques plus courts pour certains produits. Les commandes fournisseurs sont revues chaque semaine et le délai habituel est de deux semaines.
Le projet ne commence pas sur tout le catalogue. L’équipe choisit une famille disposant d’un historique exploitable et d’un enjeu de stock identifié. Elle agrège les ventes par semaine, rapproche les disponibilités et consigne les promotions programmées.
Dans ce cas, intelligence artificielle et machine learning servent à estimer les volumes des trois semaines suivantes : deux semaines de délai et une semaine jusqu’à la prochaine revue. La prévision sera comparée à la méthode actuellement utilisée, pas seulement à une impression humaine.
Le jeu de données contient une ligne par référence et semaine, avec une quantité cible. Les variables peuvent inclure les ventes des semaines précédentes, une moyenne récente, le prix et le calendrier promotionnel connu. Les nouvelles références restent traitées séparément tant que leur historique est trop court.
Choisir le modèle le plus simple qui améliore la référence
Commencez par une référence simple : reprendre la dernière semaine, utiliser une moyenne mobile ou reproduire une semaine comparable de l’année précédente lorsque cela a du sens. Ces approches constituent un point de comparaison obligatoire, pas un embarras à dissimuler.
Les modèles statistiques de séries temporelles, comme le lissage exponentiel, conviennent à certains profils de tendance et de saisonnalité. La régression et les arbres de décision combinés, notamment le gradient boosting, permettent d’exploiter plusieurs facteurs. Leur intérêt doit être démontré sur vos données.
Un modèle partagé entre plusieurs références peut apprendre des régularités communes. À l’inverse, une demande intermittente, caractérisée par de longues périodes sans vente, appelle une évaluation spécifique et parfois des méthodes dédiées. Aucun algorithme ne gagne dans toutes les situations.
Associer intelligence artificielle et machine learning n’impose donc pas un réseau neuronal. Si une moyenne mobile produit des décisions aussi bonnes pour moins de maintenance, conservez-la. Notre explication des différences entre règles déterministes et IA aide à situer cette frontière.
Un modèle génératif peut expliquer un résultat ou structurer des informations commerciales. Il ne remplace pas, à lui seul, un système de prévision numérique évalué.
Tester sans laisser le futur contaminer le passé
Une séparation aléatoire des lignes est généralement inadaptée aux séries temporelles. Elle peut laisser des informations futures influencer l’apprentissage. La validation doit reproduire la situation réelle : à chaque date de décision, le modèle ne connaît que ce qui était alors disponible.
Utilisez une validation chronologique glissante. Entraînez le modèle sur une première période, prévoyez les semaines suivantes, puis avancez la date de coupure et recommencez. Le principe est détaillé dans la validation croisée temporelle présentée par Hyndman et Athanasopoulos.
Pour notre PME fictive, les réglages sont choisis sur des fenêtres antérieures. Les douze dernières semaines constituent ensuite un test final conservé à part. L’évaluation porte sur les horizons d’une, deux et trois semaines, car une bonne prévision à court terme ne garantit pas une bonne anticipation des approvisionnements.
Ce test court ne couvre pas nécessairement toutes les saisons. Si les fêtes concentrent votre activité, évaluez aussi des fenêtres comparables sur les années précédentes et signalez les périodes pour lesquelles vous manquez encore de recul.
Dans un dispositif d’intelligence artificielle et machine learning, la fuite de données est souvent discrète. Une promotion décidée après la date simulée, un stock corrigé a posteriori ou une moyenne calculée avec des ventes futures peuvent embellir artificiellement les résultats.
Appliquez aussi les opérations de préparation sur les seules données d’entraînement. Documentez les informations indisponibles à l’époque plutôt que de construire un passé artificiellement parfait.
Mesurer l’erreur, le biais et les résultats métier
Une erreur moyenne ne suffit pas. Examinez sa taille, son sens et sa répartition entre produits. Le biais révèle une tendance à prévoir trop haut ou trop bas ; des erreurs opposées peuvent s’annuler sans rendre les décisions satisfaisantes.
Voici trois semaines fictives pour une même référence :
Semaine
Ventes réelles
Prévision
Erreur absolue
1
100
100
0
2
120
110
10
3
80
90
10
Le volume réel total est de 300 unités et l’erreur absolue cumulée de 20. Le WAPE, calculé ici comme la somme des erreurs absolues divisée par la somme des quantités réelles, vaut environ 6,7 %. Le biais global est nul : les totaux prévu et réel sont identiques, malgré deux erreurs.
Le WAPE ne se calcule pas quand la demande totale vaut zéro et favorise les références à gros volume dans une évaluation agrégée. La MAPE pose aussi problème avec des ventes nulles. Complétez ces indicateurs par l’erreur absolue en unités et une lecture par segment.
Vérifiez également la cohérence entre niveaux : les prévisions par référence devraient rester compatibles avec celles des familles et du catalogue. Une amélioration globale peut masquer une dégradation sur une référence stratégique, même si son volume de ventes est faible.
Pour juger intelligence artificielle et machine learning, suivez surtout les ruptures, le stock moyen et le niveau de service, défini explicitement. Ces résultats dépendent aussi des fournisseurs et des règles de commande : une meilleure précision ne prouve pas, seule, un gain opérationnel.
Transformer une prévision en quantité à commander
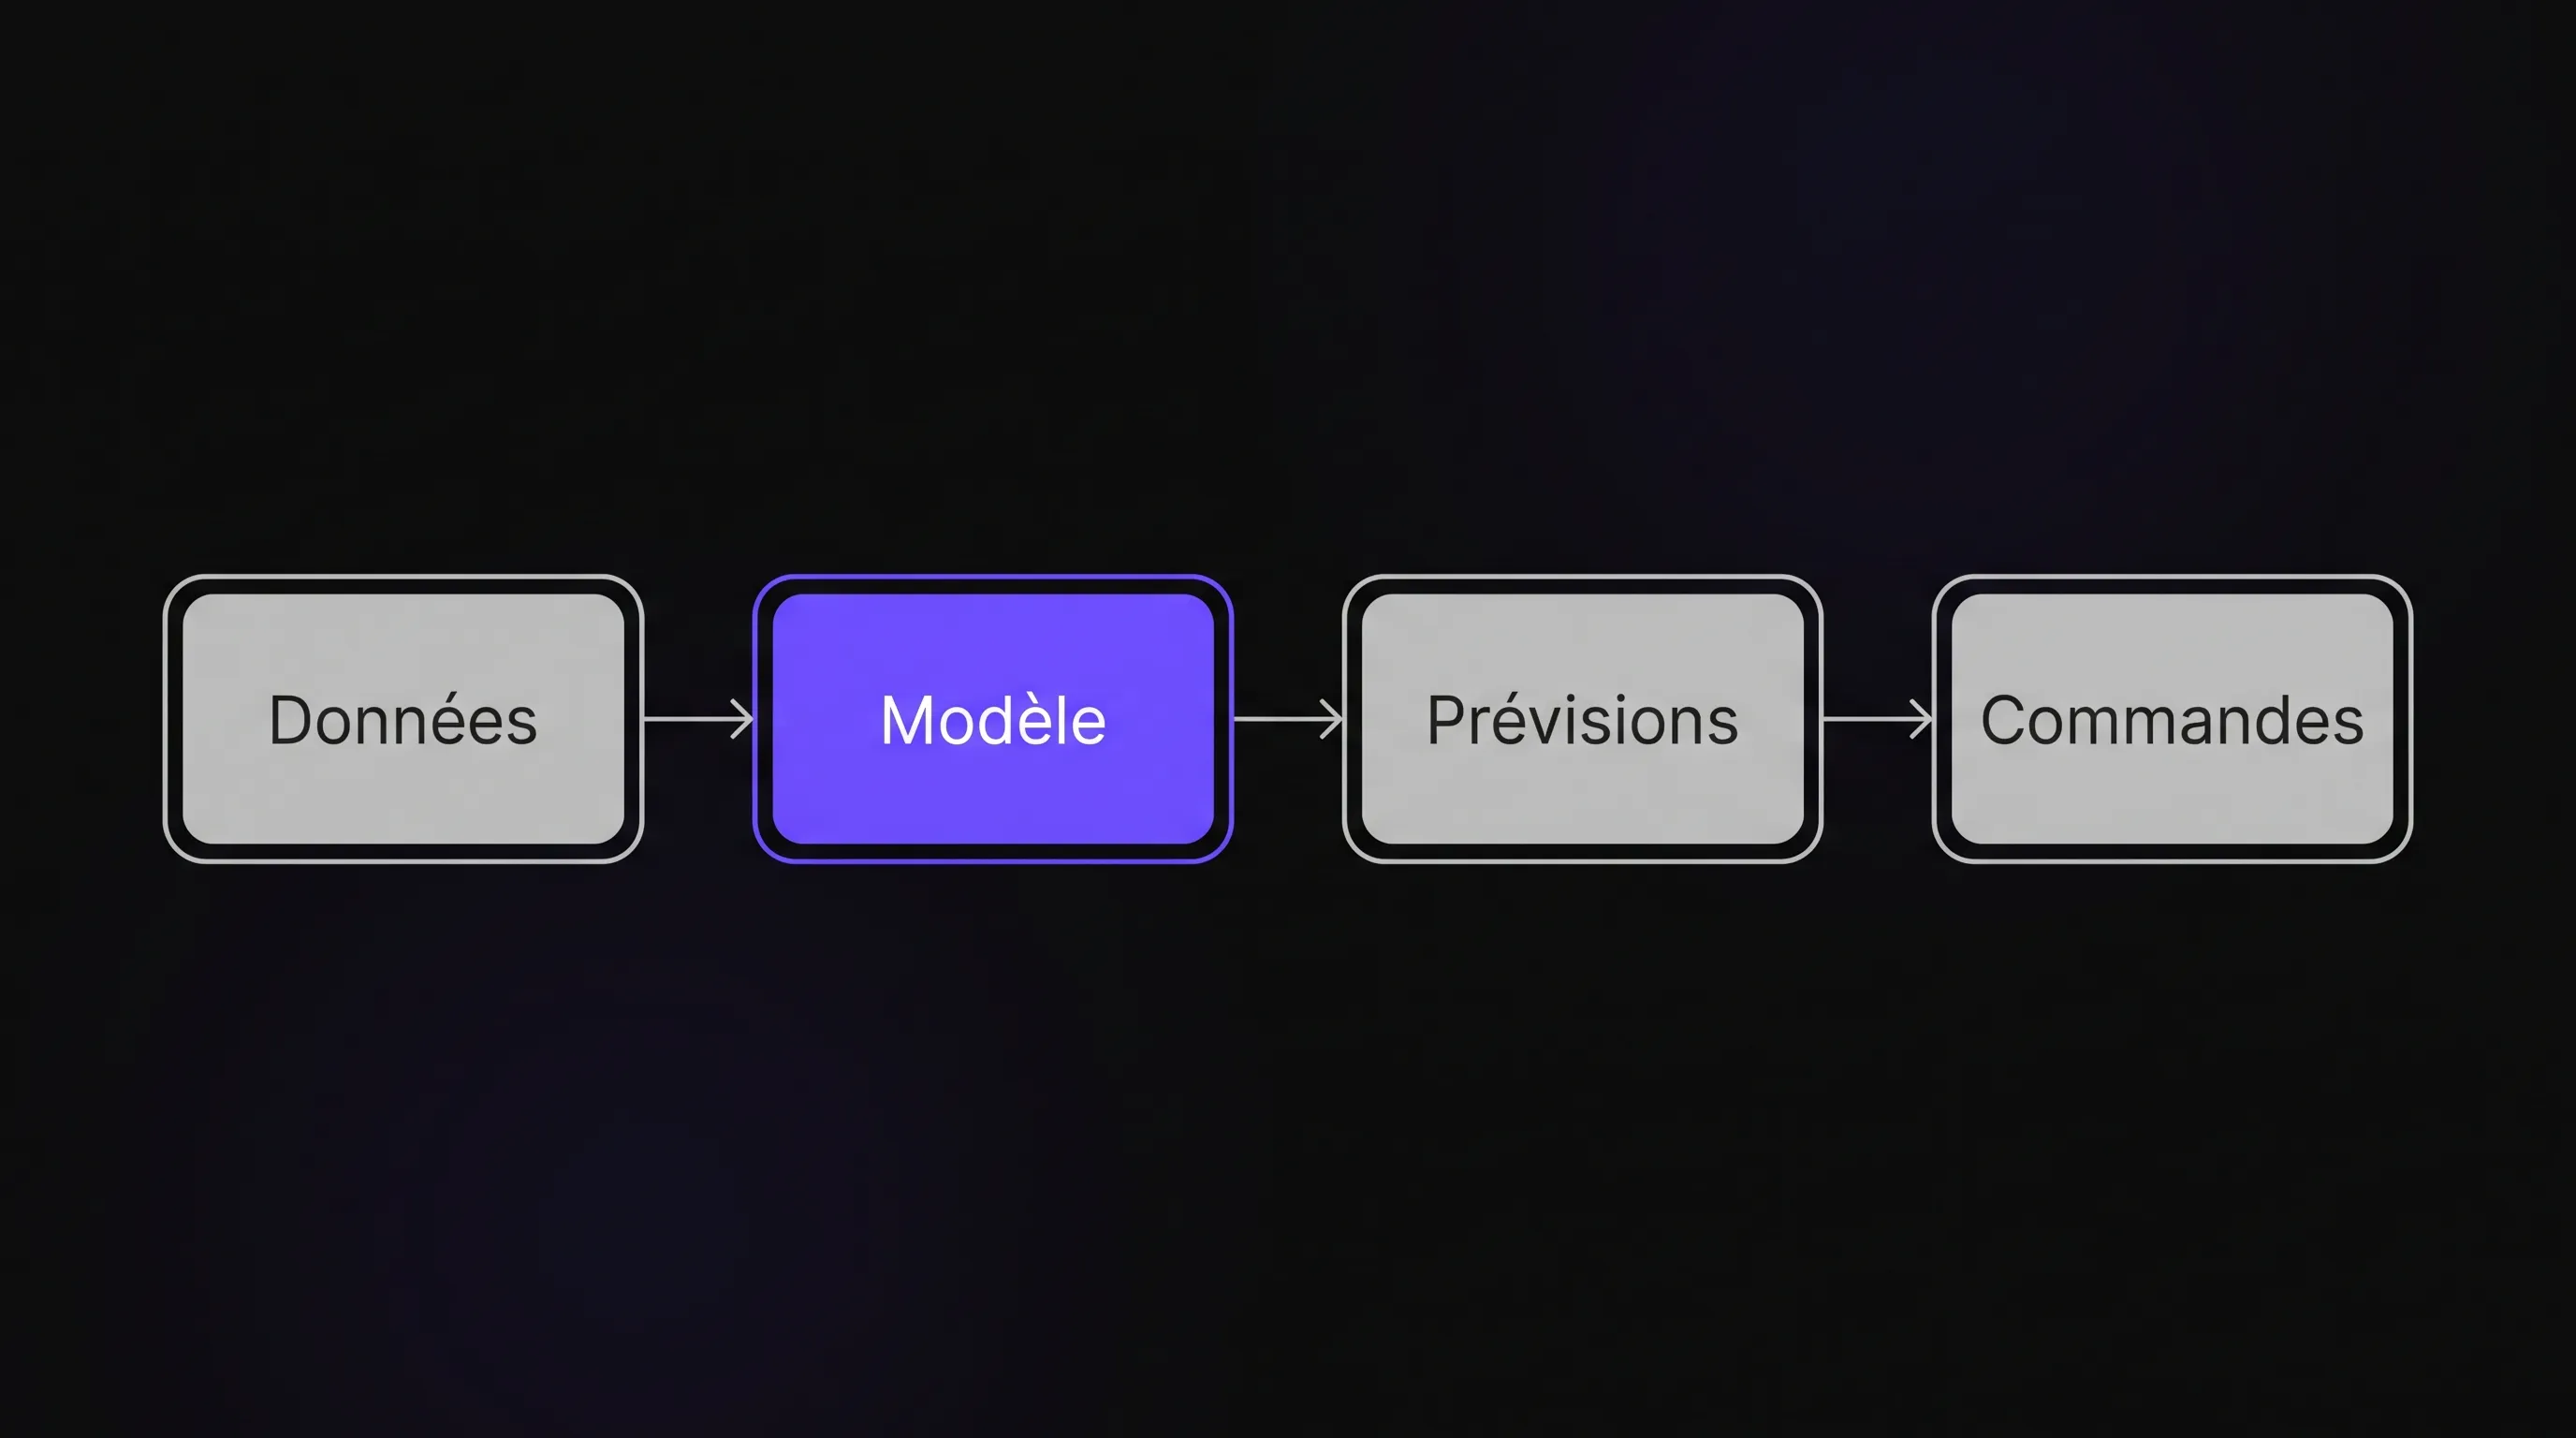
Une prévision estime un besoin. Une règle de gestion transforme cette estimation en action, en tenant compte du stock, des commandes en cours, des délais et des contraintes d’achat. C’est cette articulation qui rend intelligence artificielle et machine learning utiles au quotidien.
Reprenons notre PME avec une revue hebdomadaire et deux semaines de délai fixe. Pour une référence, les prévisions des trois prochaines semaines sont de 100, 110 et 90 unités. Le besoin attendu sur la période de protection atteint donc 300 unités.
Supposons, uniquement pour illustrer le calcul, un stock de sécurité de 60 unités. Le niveau cible est de 360 unités. L’entreprise possède 180 unités, attend 80 unités déjà commandées et doit encore servir 20 unités en retard.
Sa position de stock est de 180 + 80 - 20 = 240 unités. La proposition de commande vaut alors 360 - 240 = 120 unités, avant application des minimums de commande, conditionnements et contraintes budgétaires.
Le stock de sécurité ne doit pas être choisi arbitrairement en production. Il dépend du niveau de service recherché, des erreurs sur l’horizon pertinent et de la variabilité des délais. Il faut aussi vérifier les dates d’arrivée : une livraison tardive ne couvre pas une rupture immédiate.
Traiter les pics, les lancements et l’incertitude
Une valeur unique masque l’incertitude. Lorsque l’outil le permet, associez une prévision centrale à des quantiles ou à des intervalles, puis vérifiez leur calibration sur des données non utilisées pour l’entraînement. Un intervalle annoncé à 80 % doit contenir approximativement 80 % des observations sur des situations comparables.
Une promotion exceptionnelle, un changement de prix ou un lancement nécessite un traitement explicite. Si l’historique ne contient aucun événement comparable, le modèle ne peut pas en déduire un effet fiable. Préparez plusieurs scénarios et conservez la trace des hypothèses commerciales.
Pour les nouveaux produits, utilisez éventuellement des références analogues ou des caractéristiques communes, tout en signalant l’incertitude accrue. Une croissance rapide demande également de distinguer tendance durable et pic temporaire.
Dans ces situations, intelligence artificielle et machine learning éclairent l’arbitrage sans supprimer le jugement métier. Les corrections manuelles doivent être motivées, datées et comparées ensuite aux résultats, afin de vérifier si elles améliorent réellement la décision.
Intégrer la prévision dans le travail quotidien
Une prévision livrée dans un fichier oublié ne change rien au fonctionnement de l’entreprise. Définissez où elle apparaît : outil de gestion, application métier ou interface de réapprovisionnement. L’utilisateur doit voir la période concernée, les hypothèses principales et la date de dernière mise à jour.
Le traitement peut suivre un rythme hebdomadaire : récupérer les nouvelles données, vérifier leur cohérence, produire les prévisions puis calculer les propositions de commande. Une donnée manquante ou un volume anormal doit déclencher une alerte plutôt qu’une décision silencieuse.
Au départ, conservez une validation humaine pour les commandes. Une automatisation plus large peut ensuite être envisagée sur un périmètre maîtrisé, avec des plafonds de quantité ou de montant. Prévoyez un retour à une règle simple si le modèle ou l’alimentation des données échoue.
L’intégration d’intelligence artificielle et machine learning demande donc autant de travail sur les responsabilités que sur le code. Nommez la personne qui vérifie les anomalies et celle qui autorise les changements. Notre guide pour choisir, intégrer et mesurer une solution d’IA détaille ce passage du besoin à l’usage.
Piloter le projet sur un périmètre limité
Un pilote doit tester une décision complète, pas seulement entraîner un modèle. Choisissez un périmètre dont les données sont accessibles, les utilisateurs disponibles et les enjeux mesurables. Une famille de produits suffit si elle reflète un problème réel sans cumuler toutes les exceptions.
Formalisez dès le départ un critère de poursuite : amélioration par rapport à la prévision de référence, absence de dégradation sur les segments sensibles et charge de maintenance acceptable. Les seuils dépendent de vos coûts et de votre tolérance au risque ; ils ne sont pas universels.
Faites ensuite fonctionner les recommandations en parallèle du processus actuel avant de modifier les commandes. Cette phase révèle les données manquantes, les contraintes fournisseurs oubliées et les difficultés d’interprétation.
Elle ne mesure toutefois pas à elle seule le gain sur les ruptures : tant que les décisions restent inchangées, ce bénéfice demeure simulé. Un déploiement progressif, avec un groupe comparable lorsque c’est possible, permet une évaluation opérationnelle plus solide.
Pour comparer deux méthodes, gardez les mêmes délais, contraintes d’achat et règles de stock dans la simulation. Sinon, vous risquez d’attribuer au modèle le bénéfice d’un changement de politique commerciale ou logistique. Documentez séparément les ajustements de prévision et les ajustements de commande.
Calculer la rentabilité avec le coût complet
Le retour sur investissement d’un projet d’intelligence artificielle et machine learning ne se résume pas à quelques points d’erreur en moins. Il dépend des décisions effectivement modifiées et du coût complet du dispositif.
Estimez la marge préservée grâce aux ventes non perdues, la baisse des coûts de possession, la réduction des démarques et le temps de planification économisé. Évitez les doubles comptes : une baisse du stock libère de la trésorerie, mais le montant libéré n’est pas un bénéfice annuel récurrent.
En face, additionnez la préparation des données, les connecteurs, le développement ou les licences, l’hébergement, la supervision et le temps consacré par vos équipes. Un modèle légèrement moins précis peut offrir un meilleur bilan s’il reste simple à exploiter.
Comparez enfin plusieurs scénarios économiques plutôt qu’un gain unique présenté comme acquis. Si le bénéfice attendu reste inférieur au coût d’entretien, une règle de réapprovisionnement mieux paramétrée constitue déjà une amélioration utile.
Protéger les données et maintenir la fiabilité
La prévision par produit ou magasin nécessite rarement l’identité des clients. Travaillez autant que possible sur des données agrégées et limitez les informations transférées aux prestataires. Si des données personnelles sont utilisées, précisez la finalité, la base légale, les accès et la durée de conservation, conformément au RGPD.
Vérifiez aussi les conditions contractuelles d’hébergement, la confidentialité des historiques commerciaux et les possibilités de suppression ou de restitution des données en fin de prestation.
La fiabilité exige aussi un suivi après déploiement. Un changement de catalogue, de canal ou de comportement d’achat peut rendre les relations apprises moins pertinentes. Surveillez l’erreur, le biais, les données manquantes et les corrections humaines, puis réentraînez lorsque cela se justifie.
Enfin, évitez que le système n’amplifie ses propres erreurs : sous-prévoir un produit réduit son stock, donc ses ventes observées. Sans suivi des ruptures, le modèle peut interpréter cette baisse comme une nouvelle diminution de demande.
Questions fréquentes
Faut-il beaucoup de données pour commencer ? Il faut surtout des données cohérentes avec le rythme de décision. L’historique nécessaire dépend de la saisonnalité, de la fréquence des ventes et des changements d’activité. Commencez par mesurer ce qu’une méthode simple permet déjà de prévoir.
Peut-on prévoir la demande avec ChatGPT ? Un assistant génératif peut aider à explorer un fichier ou à préparer une analyse. Ses réponses seules ne constituent pas un dispositif de prévision validé. Les calculs doivent reposer sur des traitements contrôlés et des tests chronologiques.
Quand le machine learning devient-il pertinent ? Lorsqu’il améliore une référence simple sur des données futures simulées, avec un gain utile pour la décision. La présence de multiples facteurs, comme les prix et les promotions, peut justifier l’essai sans garantir le résultat.
Peut-on automatiser les achats dès le lancement ? Mieux vaut commencer avec une validation humaine, des limites explicites et une procédure de repli. L’automatisation dépend de la fiabilité observée et du coût des erreurs.
Cadrer votre premier cas de prévision
Avant de choisir une technologie, réunissez un échantillon d’historique, la décision à améliorer et votre méthode actuelle. Ce socle permet d’évaluer si intelligence artificielle et machine learning apportent un avantage mesurable.
Impulse Lab accompagne les entreprises avec des audits d’opportunités IA, des développements web et IA sur mesure, des intégrations et de la formation. Pour votre projet de prévision, commencez par cadrer le besoin et la qualité des données avant de décider ce qu’il faut construire.