Prévoir les pannes dans l’industrie avec l’intelligence artificielle
Intelligence artificielle
Stratégie IA
Automatisation
Optimisation
Pour une PME, le sujet « intelligence artificielle industrie » prend tout son sens lorsqu’il aide à anticiper une panne plutôt qu’à subir un arrêt de production. Mais installer des capteurs et entraîner un modèle ne suffit pas : une alerte n’a de valeur que si l’équipe de maintenance peut agir à tem...
octobre 11, 2026·11 min de lecture
Pour une PME, le sujet « intelligence artificielle industrie » prend tout son sens lorsqu’il aide à anticiper une panne plutôt qu’à subir un arrêt de production. Mais installer des capteurs et entraîner un modèle ne suffit pas : une alerte n’a de valeur que si l’équipe de maintenance peut agir à temps.
La maintenance prédictive consiste à exploiter l’état réel d’un équipement pour repérer une dégradation et préparer une intervention. Voici comment choisir un premier cas d’usage, réunir les bonnes données et vérifier que le dispositif améliore réellement votre exploitation.
Intelligence artificielle industrie : ce que l’on peut vraiment prévoir
Une IA ne connaît pas à l’avance la date de chaque panne. Elle analyse des signaux qui peuvent précéder certains défauts : vibration inhabituelle, dérive de température, hausse du courant moteur ou évolution de la pression.
Trois approches doivent être distinguées :
Maintenance préventive : intervenir selon un calendrier ou un nombre d’heures de fonctionnement, même sans signe de dégradation.
Maintenance conditionnelle : intervenir lorsque l’état mesuré dépasse un seuil ou révèle un défaut.
Maintenance prédictive : exploiter l’évolution des mesures pour estimer un risque de défaillance ou une fenêtre d’intervention.
La détection d’anomalies peut soutenir les deux dernières approches, mais une anomalie n’est pas nécessairement une panne à venir. Un changement de cadence ou de matière première peut aussi modifier les mesures.
Les meilleurs candidats présentent une dégradation progressive et observable. Un roulement qui s’use peut produire des signes avant-coureurs. Une rupture brutale sans signal mesurable reste beaucoup plus difficile à anticiper. L’objectif réaliste est donc de prévoir certains modes de défaillance, pas de supprimer tous les arrêts.
Choisir un équipement plutôt que surveiller toute l’usine
Commencez par une machine dont l’indisponibilité a un impact clair : arrêt d’une ligne, perte de production, rebut ou mobilisation urgente de techniciens. Un équipement coûteux n’est pas automatiquement le meilleur choix si une machine de secours prend immédiatement le relais.
Pour sélectionner le premier périmètre, examinez quatre éléments : la criticité de l’équipement, la fréquence des incidents, la disponibilité des mesures et la possibilité d’intervenir après une alerte.
Une pompe régulièrement arrêtée pour une dégradation identifiable peut être un meilleur point de départ qu’un parc entier de machines très différentes. Le périmètre initial devient alors : une famille d’équipements, un défaut ciblé et une décision de maintenance précise.
Dans l’industrie, l’intelligence artificielle apporte surtout de la valeur lorsque le délai d’alerte correspond à une action possible. Si une pièce demande plusieurs jours d’approvisionnement, une alerte quelques minutes avant la panne ne résout pas le problème.
Définissez la décision avant le modèle : inspecter au prochain changement d’équipe, commander une pièce ou programmer une intervention pendant un arrêt déjà prévu.
Quelles données faut-il pour anticiper une panne ?
Les données utiles se trouvent souvent dans plusieurs systèmes. Les automates et la supervision industrielle renseignent le fonctionnement des machines. Les capteurs mesurent leur état. La GMAO, ou gestion de maintenance assistée par ordinateur, conserve les interventions et les défauts constatés.
Les vibrations peuvent aider à observer certains défauts mécaniques. La température, le courant électrique, la pression ou le débit apportent d’autres indices selon l’équipement. Leur pertinence doit être validée avec les personnes qui connaissent la machine.
Le contexte est tout aussi important : vitesse de rotation, charge, produit fabriqué, démarrage ou fonctionnement stabilisé. Une mesure normale à pleine charge peut paraître anormale au ralenti.
Avant d’utiliser l’intelligence artificielle dans l’industrie, vérifiez la synchronisation des horodatages, les unités et l’identification des équipements. La fréquence d’acquisition doit aussi correspondre au phénomène observé : une moyenne horaire peut masquer un événement bref.
Un historique abondant mais mal relié aux interventions sera moins exploitable qu’un historique plus court, correctement documenté.
Comment démarrer lorsque les pannes sont rares ?
Avec peu d’exemples de défaillance, un modèle supervisé risque d’apprendre des particularités accidentelles plutôt que des signes fiables de panne. Il faut aussi éviter de classer comme « sain » tout fonctionnement simplement parce qu’aucun incident n’a été enregistré.
Une première étape peut consister à caractériser les régimes de fonctionnement habituels, puis à repérer des écarts persistants. Ces écarts deviennent des demandes d’inspection, pas des diagnostics automatiques.
Chaque inspection enrichit ensuite l’historique : défaut confirmé, absence de défaut, pièce remplacée ou cause différente. Cette boucle de retour terrain permet de mieux comprendre quelles alertes sont réellement utiles.
Quel modèle choisir pour la maintenance prédictive ?
Le bon choix dépend davantage des données et du défaut recherché que de la sophistication de l’algorithme. Une règle métier bien conçue doit servir de point de comparaison : si elle répond au besoin, ajouter de l’IA n’est pas forcément rentable.
Approche
Usage pertinent
Limite principale
Seuils et règles métier
Surveiller une limite connue ou une dérive simple
Peuvent manquer des interactions entre plusieurs signaux
Détection d’anomalies
Repérer un comportement inhabituel avec peu de pannes documentées
Ne prouve pas qu’une défaillance approche
Modèle supervisé
Reconnaître un défaut à partir d’exemples fiables
Dépend de la qualité des incidents étiquetés
Estimation de durée de vie restante
Estimer un horizon avant défaillance pour une dégradation suivie
Demande des historiques adaptés et une incertitude explicite
Un score d’anomalie ne doit pas être présenté comme une probabilité de panne sans validation adaptée. De même, une estimation de durée de vie restante doit être accompagnée de son incertitude, pas affichée comme une échéance certaine.
L’intelligence artificielle dans l’industrie peut également aider à résumer des comptes rendus de maintenance. Ce rôle documentaire est distinct de la prédiction fondée sur les mesures physiques : un chatbot ne remplace pas un modèle validé sur les équipements concernés.
Construire un pilote utilisable par les techniciens
Cadrer le défaut, l’horizon et la réponse attendue
Un pilote doit répondre à une question vérifiable. Par exemple : peut-on détecter les signes d’un défaut de roulement assez tôt pour permettre une inspection avant un arrêt non planifié ?
Le responsable maintenance définit le défaut ciblé et le délai utile. L’équipe de production précise les contraintes d’intervention. La personne chargée des données vérifie que les signaux nécessaires sont accessibles.
Convenez aussi des critères d’acceptation avant les essais : nombre maximal d’alertes inutiles, proportion d’événements détectés et délai minimal pour agir. Ces critères doivent refléter les capacités de l’équipe, pas seulement une ambition technique.
Tester sans modifier le fonctionnement des machines
Commencez par une période d’observation pendant laquelle le dispositif calcule ses alertes sans piloter les équipements. Les techniciens comparent ces alertes aux mesures disponibles, aux inspections et aux événements réels.
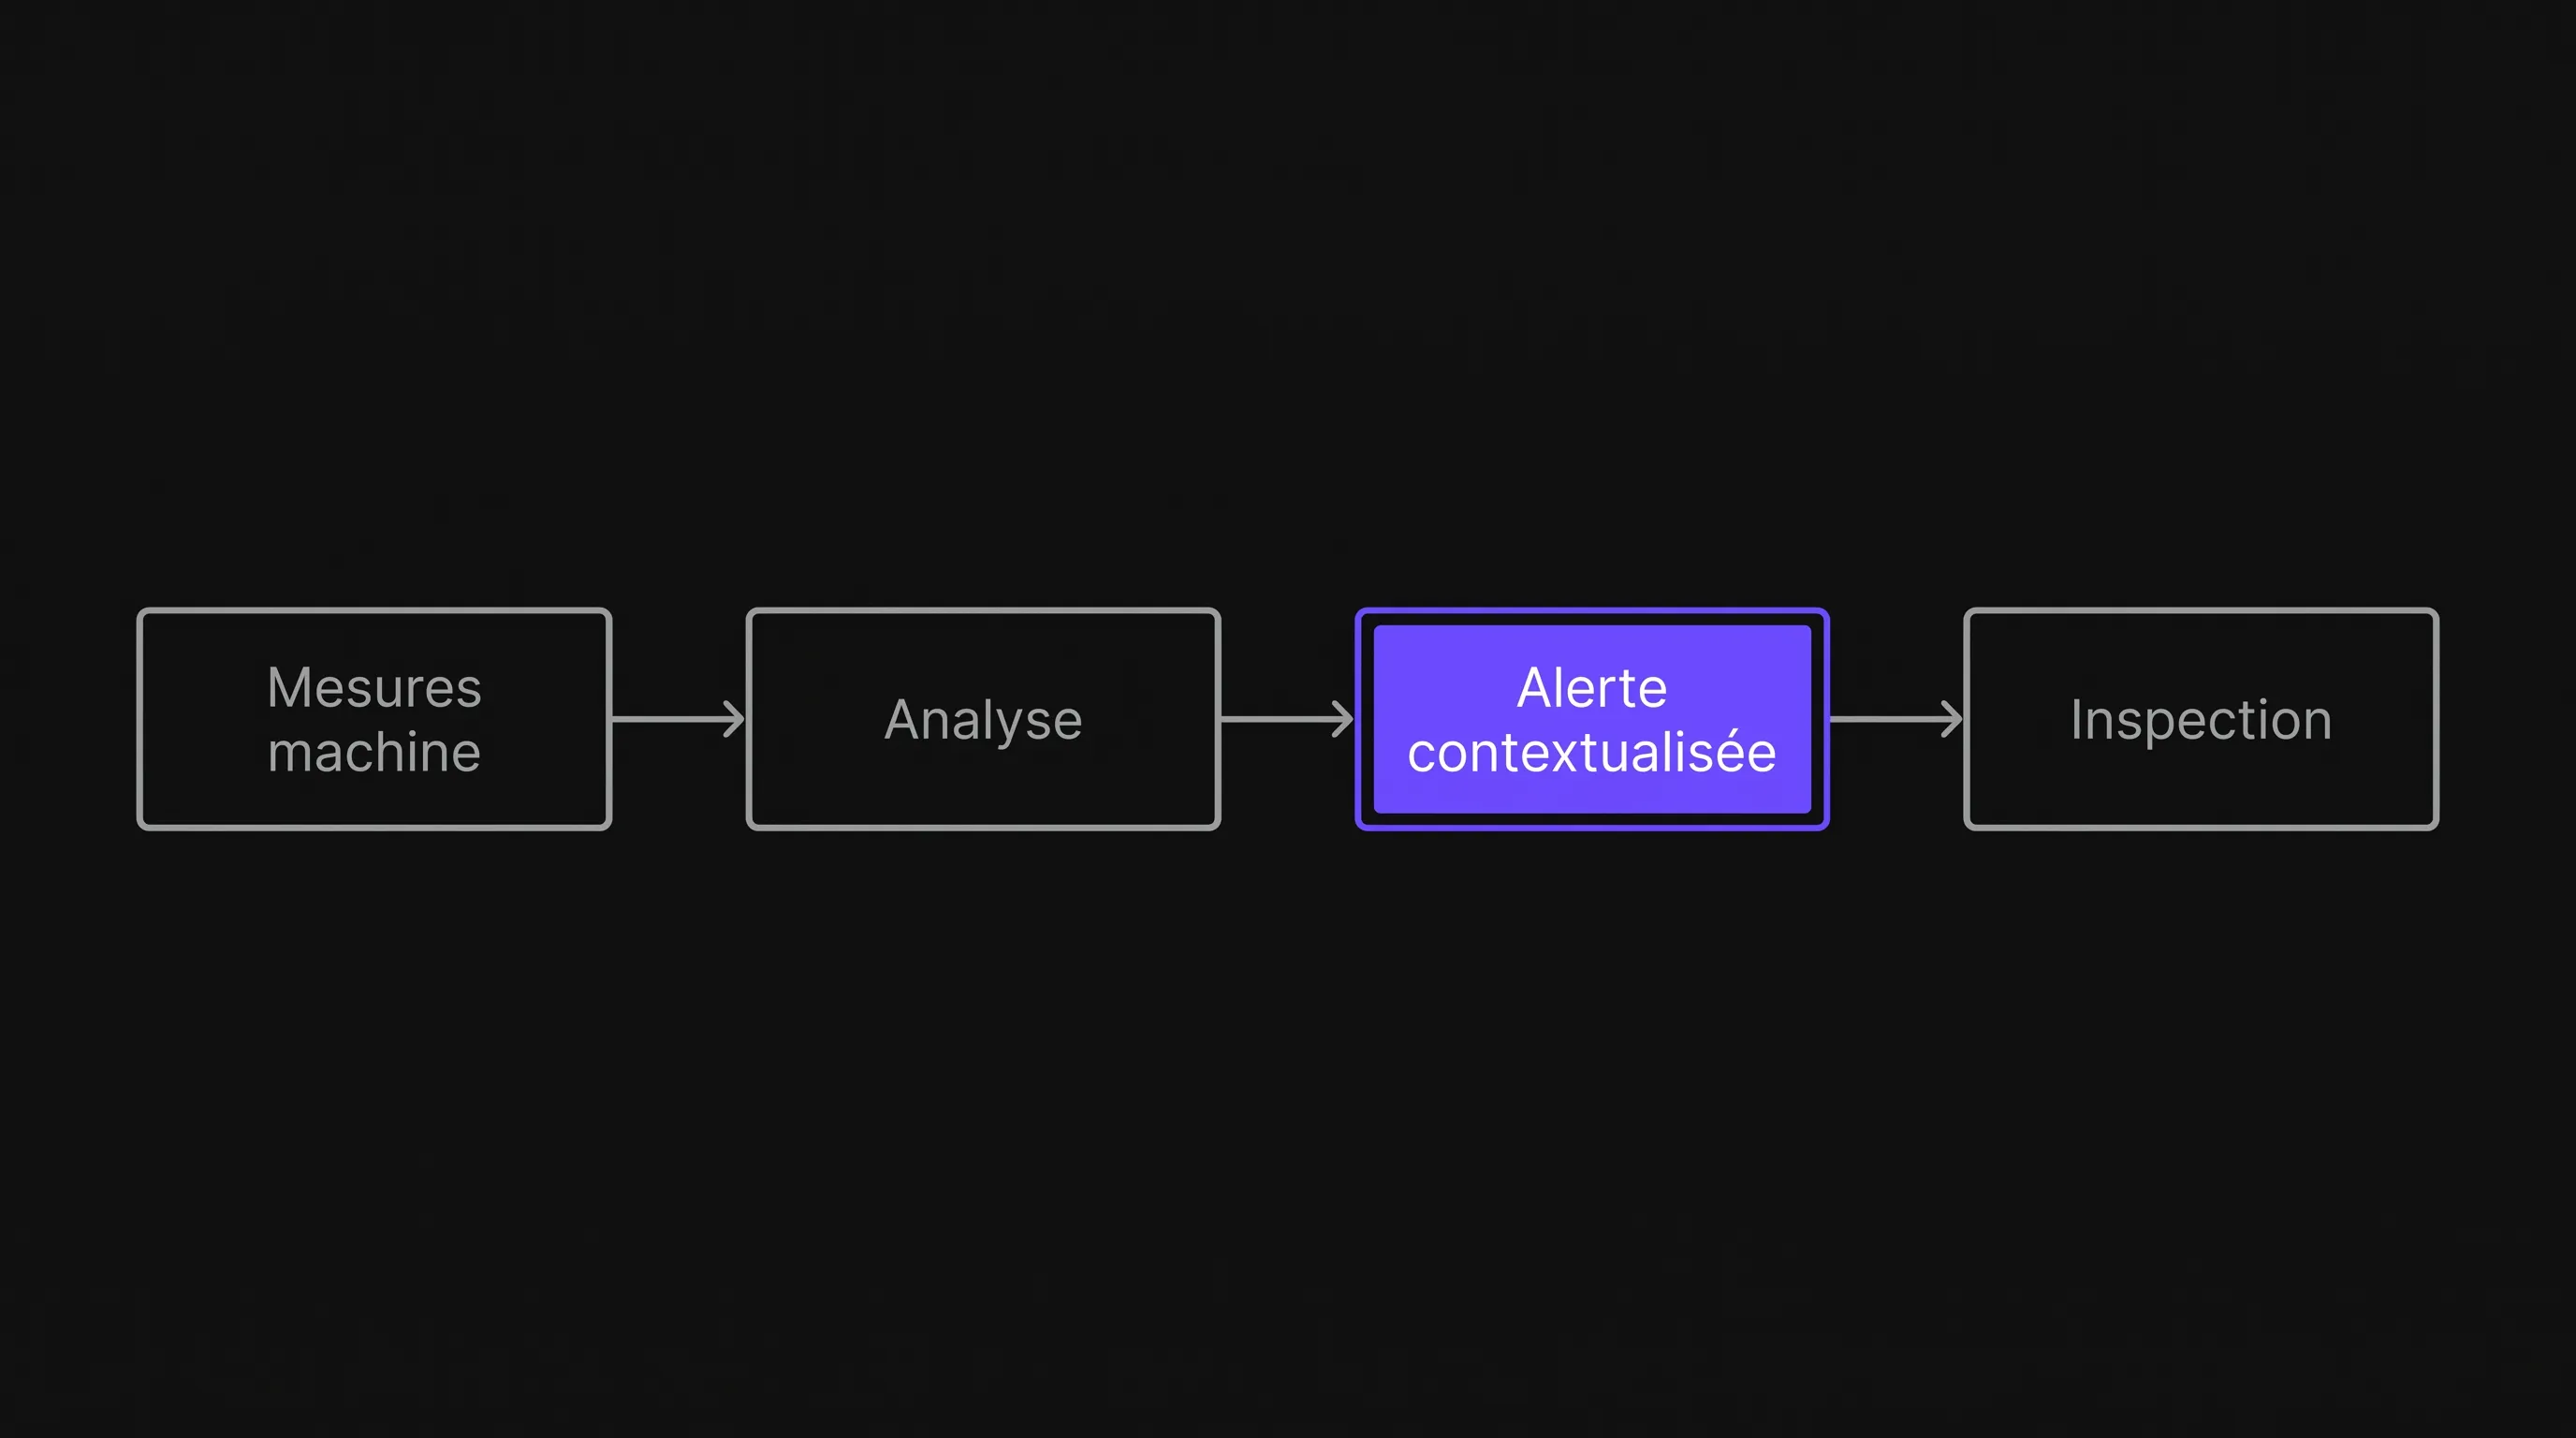
Une alerte exploitable indique l’équipement concerné, les signaux qui ont changé, le régime de fonctionnement et l’action proposée. « Risque élevé » seul ne suffit pas pour décider d’une intervention.
Prévoyez un destinataire et une procédure de traitement. Selon votre organisation, cela peut passer par une notification ou une demande d’inspection dans la GMAO. L’intégration doit éviter de créer une nouvelle boîte de réception que personne ne consulte.
Pour que l’intelligence artificielle dans l’industrie reste utile au quotidien, chaque alerte doit recevoir un retour : confirmée, non pertinente ou impossible à vérifier. Ce suivi permet d’ajuster le dispositif et de mesurer la charge qu’il impose réellement.
Mesurer les résultats sans se laisser tromper par un bon score
Évaluer des événements, pas seulement des lignes de données
Les pannes étant souvent rares, un modèle peut afficher un excellent taux global de bonnes réponses tout en ne détectant aucun incident. Le nombre de mesures correctement classées n’est donc pas le seul indicateur pertinent.
Suivez plutôt la proportion de défaillances ciblées détectées, les fausses alertes par équipement et par période, ainsi que le délai entre l’alerte et l’événement. Ajoutez le temps passé à vérifier les alertes : cette charge fait partie du coût du dispositif.
Plusieurs notifications issues d’une même dégradation doivent être regroupées en un événement. Sinon, le système peut sembler détecter beaucoup de défauts alors qu’il répète la même alerte.
Les essais doivent respecter la chronologie : entraîner sur le passé, puis évaluer sur une période ultérieure. Mélanger aléatoirement des mesures proches peut rendre le test artificiellement favorable. Il faut également exclure toute information qui n’aurait pas été disponible au moment de l’alerte.
Enfin, distinguez un défaut confirmé d’un arrêt effectivement évité. Pour évaluer l’intelligence artificielle dans l’industrie, l’historique d’une alerte doit relier le signal, l’inspection, l’action réalisée et son résultat.
Calculer la rentabilité avec des hypothèses explicites
Le gain économique ne se résume pas au chiffre d’affaires théorique d’une ligne arrêtée. Certaines productions peuvent être rattrapées et tous les coûts ne disparaissent pas lorsque l’arrêt est évité. Utilisez un coût horaire validé avec la production et la finance.
Voici un exemple fictif, destiné uniquement à illustrer le calcul. Il ne représente ni un résultat client ni un tarif d’Impulse Lab.
Hypothèse annuelle
Montant illustratif
20 heures d’arrêt évitées à 750 € par heure
15 000 €
Coût additionnel des inspections et interventions
4 000 €
Coût récurrent du dispositif
3 000 €
Gain net annuel avant investissement initial
8 000 €
Avec un investissement initial hypothétique de 16 000 €, le retour simple serait de deux ans, à condition que les gains se réalisent et se maintiennent. Le calcul doit être refait avec vos propres coûts et vos résultats observés.
Incluez les capteurs éventuels, l’intégration, l’hébergement, le suivi des modèles et le temps des équipes. Comparez aussi le projet à des solutions plus simples : meilleure lubrification, remplacement préventif ciblé ou amélioration de l’accès aux pièces de rechange.
Pour un premier déploiement, privilégiez une collecte en lecture seule et maîtrisez les accès entre le réseau industriel et les services d’analyse. Un outil d’alerte ne doit pas devenir implicitement un système qui commande une machine.
Il faut également détecter les problèmes du dispositif lui-même : capteur débranché, données figées, horloge décalée ou changement d’unité. L’absence d’alerte ne garantit pas le bon état de l’équipement, notamment si les mesures ne remontent plus.
Après une modification de machine, de cadence ou de procédé, vérifiez à nouveau les performances. Un comportement devenu normal peut continuer à déclencher un ancien modèle. À l’inverse, une nouvelle dégradation peut lui échapper.
Déployer l’intelligence artificielle dans l’industrie demande donc un responsable du suivi, une procédure de retour au fonctionnement habituel et une documentation accessible. Les risques liés à l’IA en entreprise et leurs contrôles complètent ce travail sur les accès, les données et la supervision humaine.
Questions fréquentes
Peut-on commencer sans ajouter de capteurs ? Oui, si les mesures déjà disponibles dans les automates, la supervision ou les historiques couvrent le défaut recherché. Des journaux d’intervention seuls peuvent aider à analyser les incidents, mais ne suffisent pas nécessairement à prévoir une dégradation physique.
Combien de temps faut-il pour valider un pilote ? Cela dépend de la fréquence des événements et des conditions de fonctionnement observées. Quelques semaines sans panne ne prouvent pas que le système fonctionne. Le test doit couvrir des situations représentatives et permettre de mesurer les fausses alertes.
L’IA peut-elle arrêter automatiquement une machine ? Une alerte de maintenance n’est pas, par défaut, une fonction de sécurité. Toute action automatique sur un équipement exige une conception et une validation adaptées. Pour un premier projet, conservez la décision d’intervention dans un processus humain défini.
Quand faut-il renoncer au projet ? Lorsque le défaut ne produit aucun signal exploitable, que l’alerte arrive trop tard ou que son traitement coûte plus que le bénéfice attendu. Améliorer la maintenance préventive peut alors être une meilleure décision.
Identifier un premier cas d’usage avec Impulse Lab
Avant d’investir, réunissez l’historique des arrêts d’un équipement critique, les mesures disponibles et les contraintes d’intervention. Ces éléments permettent de vérifier si la maintenance prédictive répond à un problème observable et économiquement pertinent.
Impulse Lab propose des audits d’opportunités IA, le développement de solutions sur mesure, l’intégration aux outils existants et la formation à leur adoption. Le premier échange peut ainsi porter sur une question concrète : quel défaut surveiller, avec quelles données et pour permettre quelle décision de maintenance ?